Appearance
Q139 · 什么是 GSM8K?如何评估数学推理能力?
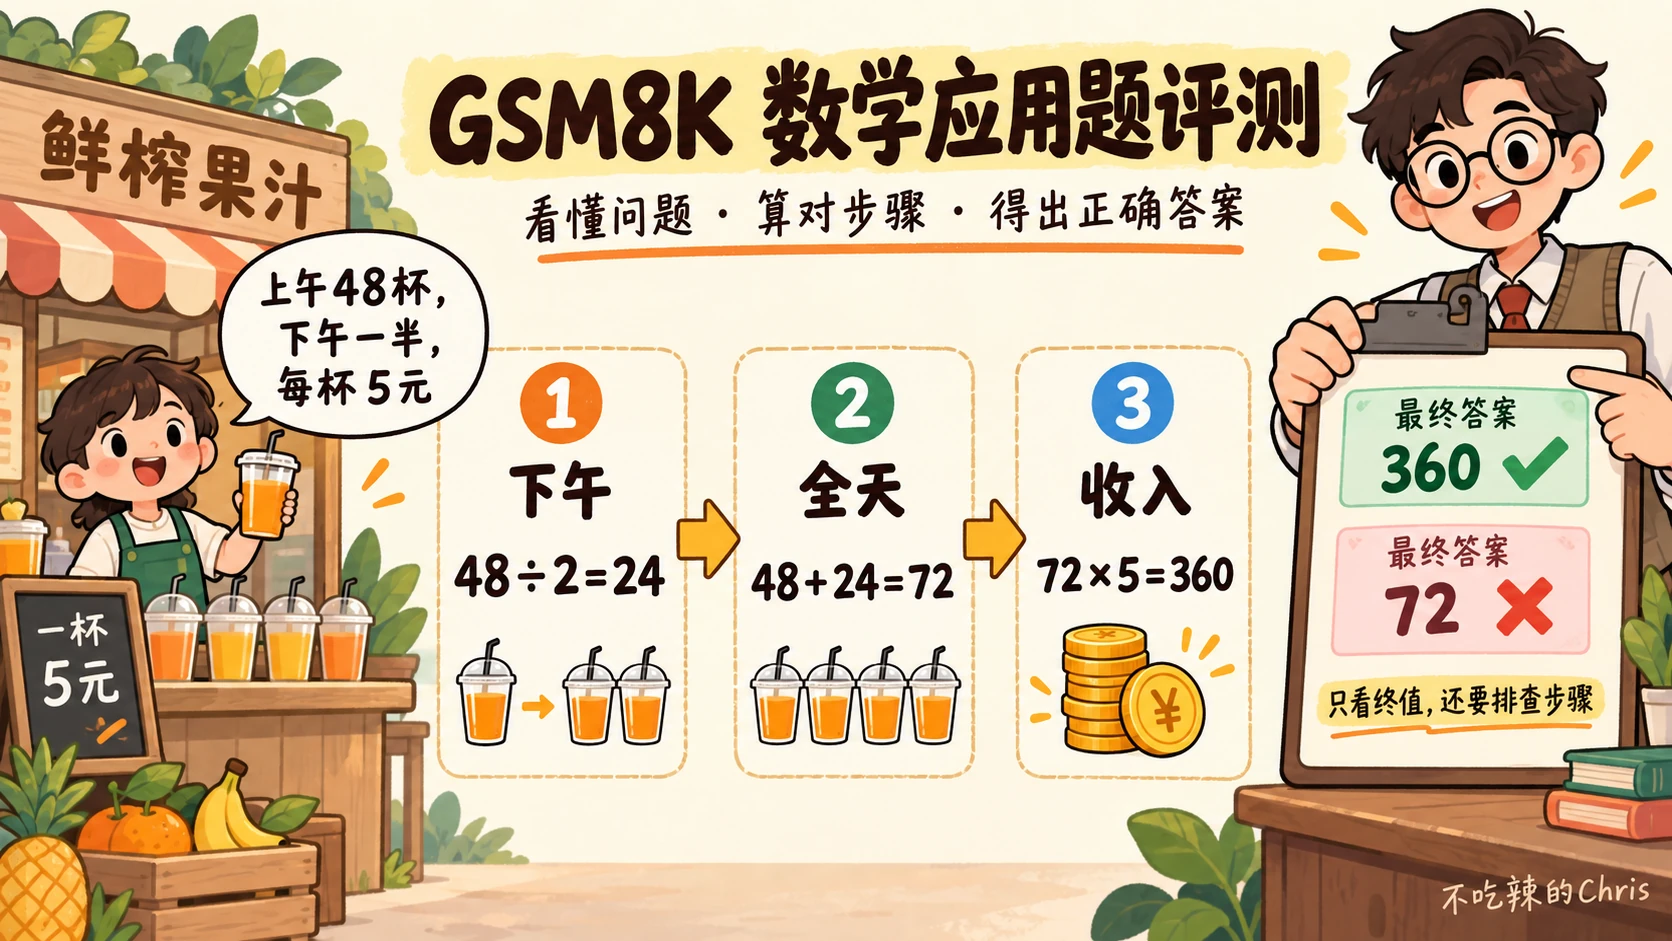
假设题目是:“果汁店上午卖出 48 杯,下午卖出上午的一半,每杯 5 元。全天收入多少元?”人要先理解“一半”修饰的是杯数,算出下午 24 杯,再算总共 72 杯,最后乘单价,得到 360 元。模型若答“72 元”,算术步骤可能没错,但它把“杯数”错当成题目要的“收入”。这类多步文字应用题,是 GSM8K 想用来观察的能力。
GSM8K 是 Grade School Math 8K 的简称,原论文《Training Verifiers to Solve Math Word Problems》发布的一组英文小学数学文字题。论文称它约有 8.5K 道,题目通常需要 2~8 步,用加减乘除组合求解;OpenAI 官方数据集卡所列的实际 main 划分是训练集 7473 道、测试集 1319 道,合计 8792 道。“8K / 8.5K”是名称与近似描述,不应用来代替发布文件的准确行数。原始论文 · OpenAI 官方仓库 · OpenAI 数据集卡
先认识术语与符号
| 术语 | 这里的意思 |
|---|---|
| 文字应用题 | 数字藏在自然语言情境里;要判断数量、关系和目标,不能只看到数字就运算。 |
| 数据集与样本 | 数据集是一批题;一条样本包含 question(题干)和 answer(参考解答)。 |
| 训练集 / 测试集 | 训练集可用于学习、调整方法;测试集用于按既定规则衡量未见题表现。若测试题进入训练或调参,测试分数会失真。 |
| 参考解答 / 最终答案 | answer 含文字步骤、计算标记和末行的数值答案;最终答案前有 ####,如 #### 360。 |
| 精确匹配(exact match) | 按预先固定的抽取与规范化规则取出模型最终答案,与标准数值字符串相等就计 1 分,否则计 0 分。 |
| 正确率 | 正确题数 ÷ 测试题总数。例如测试 1319 道中对 1000 道,得 1000 ÷ 1319 ≈ 75.8%;此处只是演示算法,不是某模型成绩。 |
| 评测协议 | 提示词、示例题数量、模型与版本、是否给计算器、生成次数、抽样参数、答案抽取器等共同组成的一套可复现规则。 |
| 数据污染 | 测试题或高度近似的题出现在训练、微调、提示示例、工具缓存或开发调参中,使分数高估陌生题能力。 |
原始发布的每行数据是带 question 和 answer 的 JSON;answer 不是只有最后一个数字,而是包含自然语言步骤和形如 <<48/2=24>> 的计算标记,最终数值在 #### 后。官方还提供 socratic 格式,它给步骤加上引导性小问题;它不是另一批独立的测试题,不能把两个配置的测试集相加后说有 2638 道新题。论文中的实验也未使用这一 Socratic 格式。OpenAI 官方仓库:数据与格式 · OpenAI 数据集卡:配置与划分
同一道题怎样从题干走到答案
上面的果汁店题是自拟教学例子,用于说明 GSM8K 风格的解题和判分,并非声称它在官方测试集中。
- 读清目标和单位。 已知上午
48 杯,下午是上午杯数的1/2,单价5 元/杯;问题要的是“全天收入”,单位应为元。 - 求缺失的中间量。 下午杯数
48 ÷ 2 = 24 杯。如果把“一半”误解成全天的一半,关系从第一步就错了。 - 合并同单位的量。 全天杯数
48 + 24 = 72 杯。这一步得到的是杯数,还不是收入。 - 换算目标量。
72 杯 × 5 元/杯 = 360 元。杯在乘法中约掉,单位也能帮助发现漏乘单价的问题。 - 输出可判的最终答案。 为模仿官方仓库的原始格式,可以写
#### 360。参考解答中的步骤可供人检查,但标准的最终答案正确率通常比较的是抽取后的数值,不是逐字匹配整段讲解。
原始仓库的 dataset.py 给出一个具体的判分实现:正则表达式从 #### 后抽取数值字符,去掉数字中的逗号,再把模型与参考答案字符串比较;抽不到就记无效。因而在这套实现中,#### 360 能匹配标准 #### 360,但若只写“360 元”而没有规定的标记,可能抽取失败。不同论文或评测框架会使用不同抽取与数字规范化规则,所以报告 GSM8K 分数时还要说明到底使用了哪套解析器,不能把一种脚本当成所有 GSM8K 结果的共同规则。OpenAI 官方判分代码
最终答案正确率能说明什么,不能说明什么
固定提示与解析规则后,逐题抽取模型最后的数值,算测试集上的正确率,是一种清楚、便宜、容易复算的结果指标。同一题若模型输出正确的“360”,不管它是心算、列式、调用计算器,结果层面都是对的;若输出“72”,结果层面是错的。这很适合比较在同一协议下的候选系统。OpenAI 官方仓库:答案提取与判分
但它并不单独证明“推理过程可靠”。模型可能写出错误中间步骤,最后碰巧得到 360;也可能思路与计算都正确,最后却输出格式不符合解析器。参考解答提供了示范步骤,却不是唯一合法的证明方式,不能要求模型每一句都与参考文字相同。原论文的验证器研究就利用“候选解答的最终答案是否正确”构造反馈,并在测试时从多个候选解答中选择;这与逐步证明每一步都正确不是同一件事。原始论文
要更完整地评估数学推理,可以把同一题拆成几层诊断:
| 层次 | 在果汁店题中检查什么 | 典型失败 |
|---|---|---|
| 读题与建模 | “下午一半”对应 48÷2;“收入”对应杯数乘单价 | 把下午 24 杯误解成全天的一半,或把杯数当收入 |
| 算术执行 | 48÷2=24、48+24=72、72×5=360 是否逐步成立 | 列式正确却算出 72×5=350 |
| 最终交付 | 数值 360、目标单位元、输出格式是否符合协议 | 算出 360 却在最后一行误写 36,或解析器读不到 |
| 稳健性 | 把 48 改成 52、换人物和语序、加入无关信息后是否仍按关系求解 | 记住原题答案,换个数字就沿用 360 |
若能看到模型展示的步骤,可由人工或另一个经过校验的程序检查可观察到的解答;这不等于读到了模型内部全部思考。对有争议的步骤让人复核,允许不同但等价的正确路径。对算术错误可用确定性计算器重算,对关系理解错误则要看题意、变量和单位,不能只靠计算器。Apple 的 GSM-Symbolic 研究在调整题中数字或添加无关条件后观察到模型成绩变化,说明单个固定题库的高分不必然代表对关系变化的稳健理解。Apple:GSM-Symbolic
公平比较两个模型,要固定哪些条件
假设模型 A 在 1319 道测试题上答对 1000 道,模型 B 答对 1050 道。仅报“75.8% 对 79.6%”还不够,至少要让两者的实验条件可比:
- 题与划分一致。 使用同一版本
main/test全量 1319 题;训练和调参只碰训练集或另留验证集。报告数据版本、过滤或剔除规则。不能在测试题上挑提示词后又把它叫独立测试。 - 提示方式一致。 零样本是只给任务说明;少样本是在提示里给示例;“请列步骤”与“只给最终数字”也会影响表现。若使用少样本示例,注明来源,并确保测试题没被放进示例。
- 生成与计算资源一致或明确标注。 单次贪心/低温生成,与每题抽多次后投票、选最好答案,不是同一计算预算。允许 Python、计算器、搜索工具的系统,也不能与纯模型闭卷分数直接视为同一能力。原论文自己的方法就使用候选解答与验证器,官方仓库也描述了计算器标记,故“GSM8K 分数”从来不是脱离设置的纯模型常数。原始论文 · OpenAI 官方仓库:计算器
- 答案提取一致。 定义是否接受逗号、空格、单位、负号、分数和多个数字;抽取失败算错还是人工复核。对 A、B 使用同一解析器,并抽样审查异常输出。
- 报告运行方式和不确定性。 记录模型标识、日期、参数、随机种子、每题采样次数、超时与失败处理;重复抽样要报告波动。比较近似分数时可对同一批题的逐题结果做配对分析,而不是只看四舍五入后的两个百分数。
这组 A/B 数字只是说明比较口径。即使 B 高 3.8 个百分点,也不能单凭此推断它会在更难的数学、几何证明、程序计算、中文题或真实教育场景里一样提高。
测试集公开后,怎样处理污染与失败
GSM8K 已公开多年,题目可能被训练语料、模型微调数据、评测提示示例或开发阶段的反复调参看到。不能仅凭高分断言某个模型被污染,也不能仅凭声称“未训练 GSM8K”就证明完全没有近似题泄漏。应做训练语料去重/近似去重审计,检查提示示例和工具检索范围;再用新写且保密的同难度题、数字扰动、改写与无关条件题交叉验证。GSM1k 的研究专门比较原 GSM8K 与新题表现,提出部分模型可能存在记忆化信号;结论是“需要进一步核验”,不是所有高分都无效。GSM1k 原始研究 · Apple:GSM-Symbolic
实际诊断可以回到果汁店题:如果模型只在原数字 48 与价格 5 时答 360,改成上午 52 杯仍答 360,便暴露了迁移问题;如果它能重新算 52÷2=26、(52+26)×5=390,才更支持其掌握了关系。即使如此,一道改写题也不足以证明普遍可靠,应在多种模板和难度上统计,并由人工审核变体题本身是否无歧义、答案是否正确。
还要避免把所有错题都归为“不会推理”。一份有用的错误报告应分开统计:读题关系错、算术错、最后抄写错、格式抽取失败、超时或工具失败。若答案解析器把正确中文表述判错,修解析器并按同一规则重跑所有模型;若标准答案本身有错,先人工核对并记录修订版本。公开仓库有问题反馈渠道,这也是为何评价前应抽查数据质量。OpenAI 官方仓库
面试中可以这样回答
“GSM8K 是原论文发布的英文小学数学文字应用题集,官方 main 数据有 7473 道训练题和 1319 道测试题。每题有题干和带步骤的参考解答,最终数值在 #### 后。标准结果评估通常先抽取模型最终答案,与标准数值做精确匹配,正确题数除以测试题数;但具体抽取器、提示方式、是否用工具和多次采样必须一起报告。我还会把读题建模、算术执行、最终输出分开看错因,因为终值正确不保证步骤都对,格式错误也可能被误判。最后用未见的新题、数字扰动和去重审计检查污染与泛化,不把 GSM8K 单一高分直接等同于全部数学推理能力。”