Appearance
Q1 · 什么是大模型 Agent?它与传统 AI 系统有什么不同?
难度 P0 必背 · 岗位 算法 / 应用 · 预计阅读 12 min 关键词 agent · intro · autonomy · tool-use · mcp · a2a
假设你让一个助手“查出今天新发布的政策,核实是否适用于我的订单,再告诉我下一步怎么办”。单次问答只能生成一段文字;要完成这件事,应用还得取回政策、查订单、判断信息是否足够,并根据每一步的结果决定下一步动作。Agent 描述的是这种围绕目标持续执行、观察结果并调整行动的系统。
先认清几个词
| 词 | 含义 | 在这个例子里 |
|---|---|---|
| LLM(大语言模型) | 根据本次输入生成内容的模型 | 阅读政策与订单信息并提出下一步 |
| 工具 | 由程序提供、可以读取资料或执行操作的能力 | 查询政策、读取有权限的订单 |
| Agent | 围绕目标选择动作、接收结果并继续决策的应用系统 | 查询后发现缺字段,继续询问或换一种查询 |
| 规划 | 决定当前先做什么,以及结果不同时如何继续 | 先找政策,再核对订单条件 |
| 闭环 | 行动的结果进入下一轮决策,直到完成或停止 | 查不到签收日时不猜测,转而补信息 |
模型可以提出工具调用请求,真正执行查询或修改数据的是应用程序。一个应用能调用工具,并不意味着它已经有可靠的多步规划、状态管理和停止条件。
先看系统之间的区别
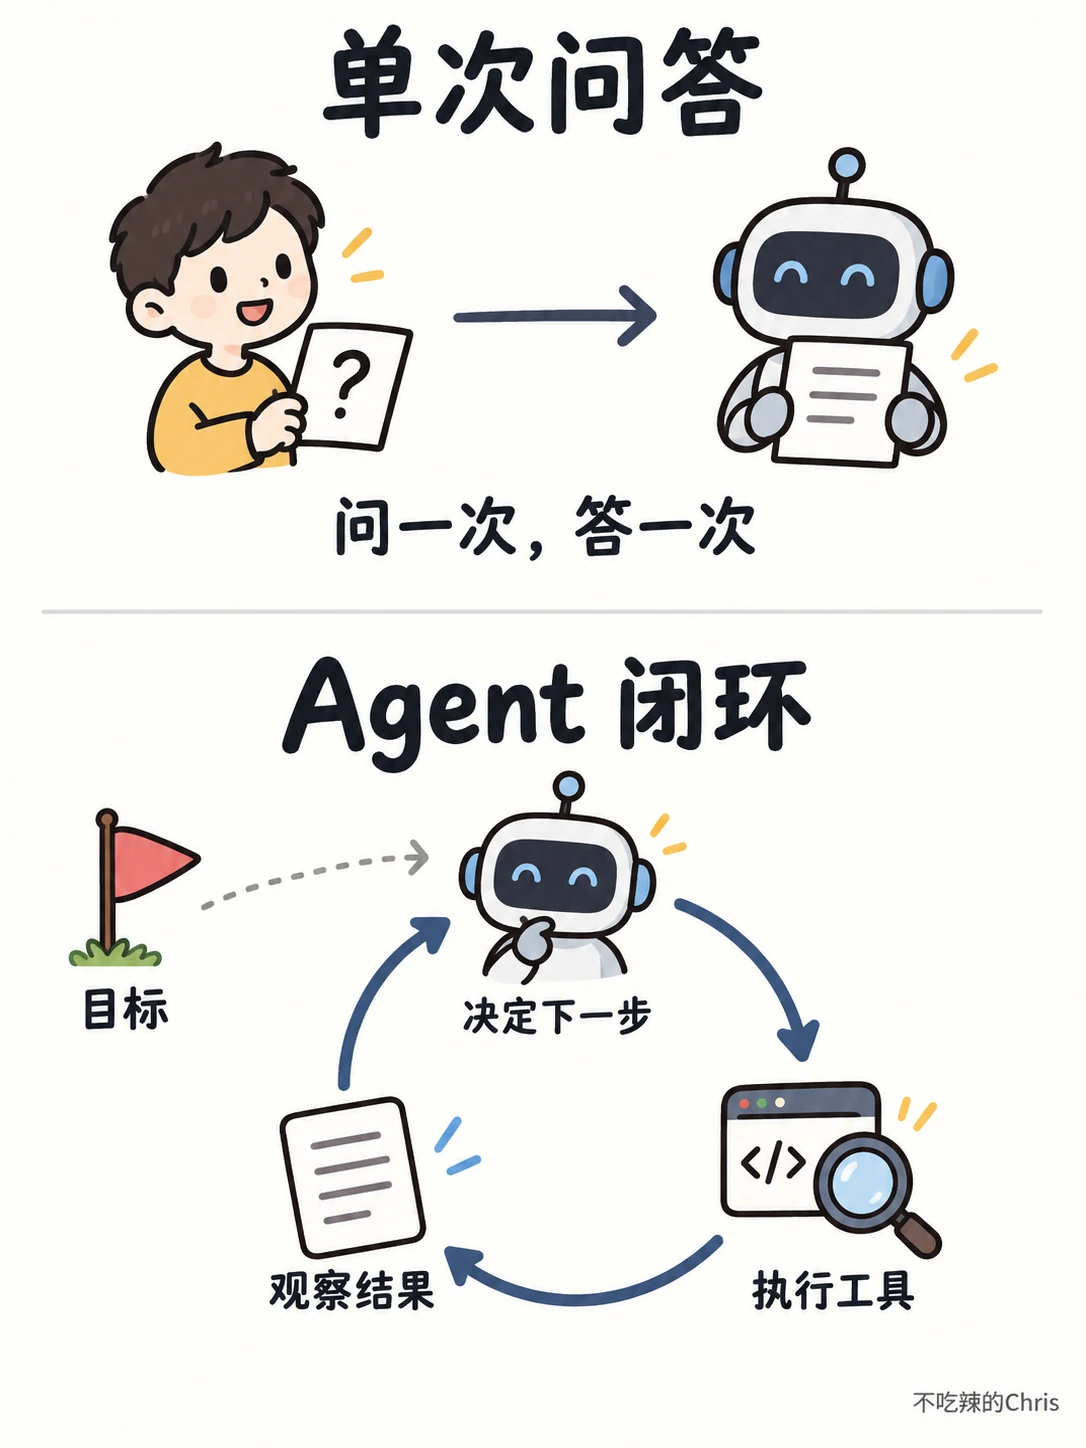
Agent 如何持续推进任务
Agent 本质上是一个能自主完成目标的 AI 系统 ,跟传统 AI 最核心的区别在于「自主性」和「能行动」。
传统 AI 是你问一个问题它回答一个问题,每次都是独立的,被动响应;而 Agent 有自己的规划能力,你给它一个复杂目标,它会自己把任务拆成多步,通过调工具、访问记忆、感知环境来一步步执行,直到完成。
它不只是输出文字,而是真的能做事。
普通大模型的三个根本局限
要理解 Agent,得先说说普通大模型的局限性在哪。
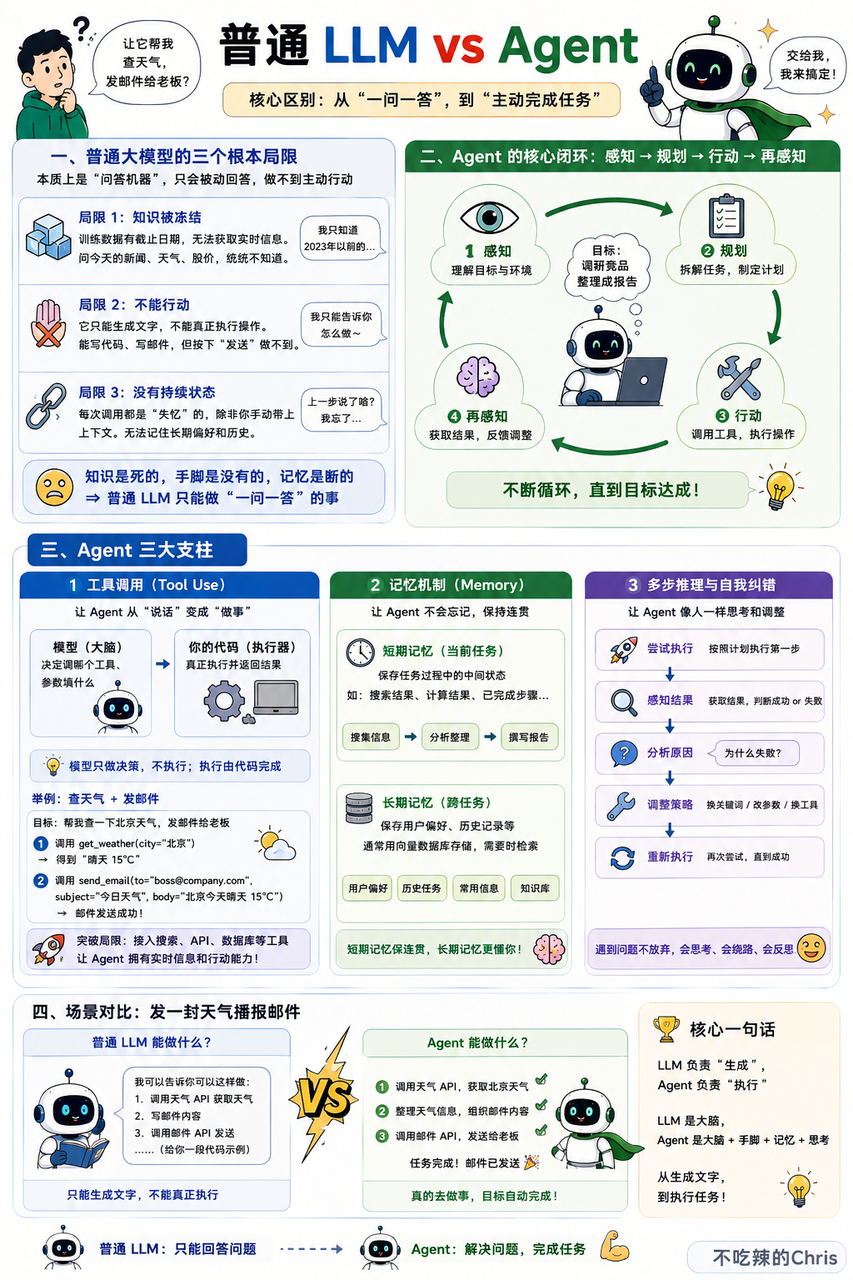
只调用模型并读取一次回复时,应用得到的是对当前输入的响应。如果想让它继续查询、保存状态和采取下一步动作,程序必须提供工具、保存必要结果,并决定是否进入下一轮。模型本身不会自动连接你的订单系统。
那普通大模型到底差在哪?我们来一层一层拆。
局限 1:知识被冻结 。模型的训练数据有截止日期,你问它今天的天气、最新的股价,它完全不知道,因为它没有任何途径去获取实时信息。这就好比一个人毕业之后就再也不看新闻了,你问他今天发生了什么,他只能给你讲课本上的知识。
局限 2:没有外部执行能力时不能行动。模型可以写邮件内容,也可以提出发送请求;是否真正发出邮件,取决于应用有没有提供相应工具,以及程序是否批准并执行这次请求。
局限 3:没有持续状态 。就算你想让它帮你做一件稍微复杂点的事,比如「先查资料再整理成报告」,它也干不了。每次调用之间它是完全失忆的,除非你手动把之前的对话塞进去,不然它根本不记得上一轮说了什么,更别说跨任务去记住你的偏好了。
这三个限制来自单次、无工具且不保存状态的调用方式。把资料检索、工具执行和状态管理接入应用后,模型就能参与多步任务;可靠性仍取决于程序的权限、校验与停止条件。
Agent 的核心闭环
Agent 就完全不一样了。它有一个核心的运作闭环:感知 → 规划 → 行动 → 再感知 。
你给它一个目标,比如「帮我调研竞品然后整理成报告」,它不是直接输出一段文字了事,而是先拆解任务,我要搜索哪些关键词、我要访问哪些网站、我要怎么组织内容,然后一步一步去执行,每一步的结果又反馈回来,指导下一步怎么做。

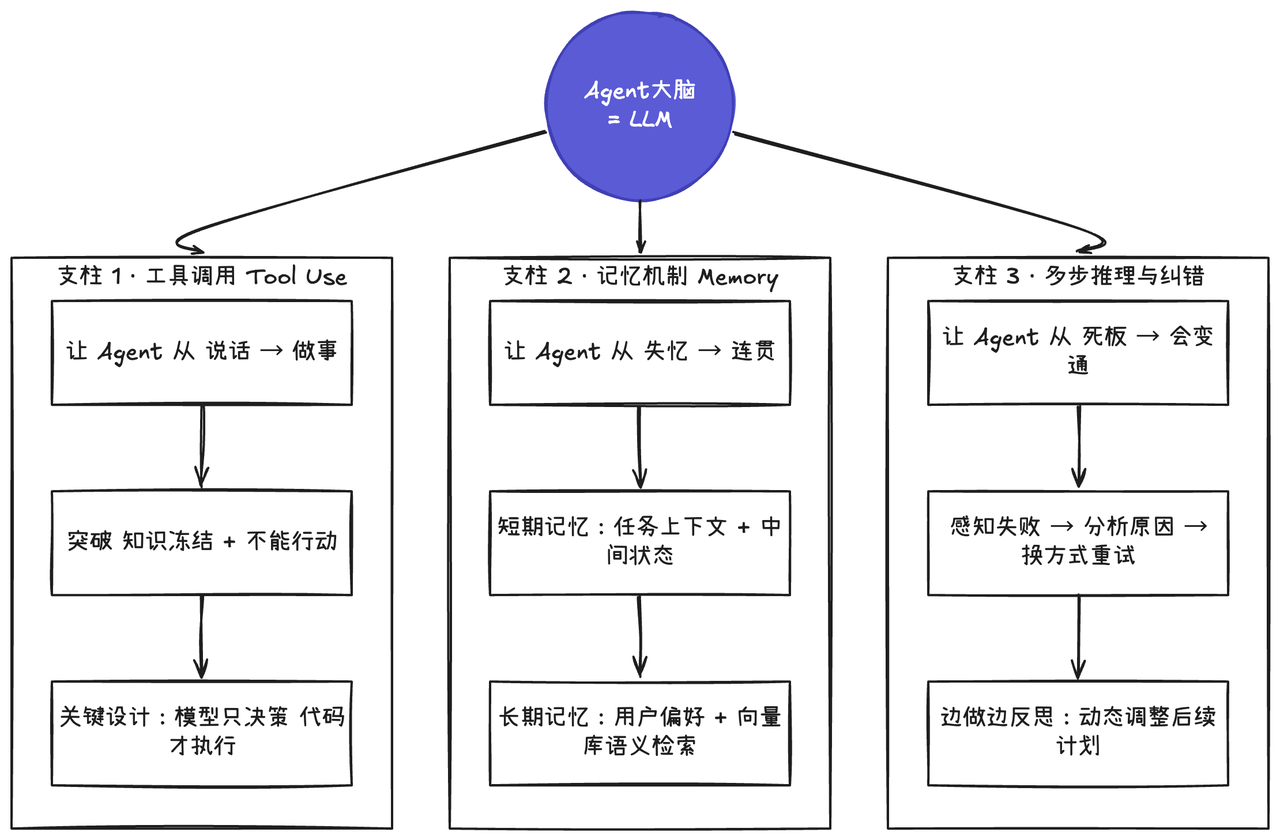
这种能力背后,有三件核心的事在支撑。
Agent 三大支柱
支柱 1:工具调用(Tool Use)
这是让 Agent 从「说话」变成「做事」的关键。Agent 能调用外部工具,比如搜索引擎、代码执行器、数据库、API 等等。不过这里有一个容易误解的地方:不是模型自己执行,而是模型「告诉你该调什么」,你的代码去真正执行,结果再反馈给模型。模型始终只是大脑,不是手脚 。
为什么工具调用如此重要?因为它一下子突破了前面说的三个局限。知识被冻结?接上搜索引擎,模型就能获取实时信息。不能行动?接上邮件 API、代码执行器,模型就能真正做事。这就好比一个人原来只能用嘴说话,现在给他配了手、脚和各种工具,能力上限瞬间拔高了一个量级。
我来举个最具体的例子。假设你给 Agent 配了两个工具:查天气和发邮件,然后让它「帮我查一下北京天气,发邮件给老板」:
python
# ↓ 步骤 1:定义工具说明书(不含执行逻辑,只是 schema)
# 注意:这里没有一行真正执行的逻辑,只是告诉模型「我有哪些能力、需要哪些参数」
tools = [
    {
        "name": "get_weather",
        "description": "获取指定城市的当前天气",
        "parameters": {
            "type": "object",
            "properties": {
                "city": {"type": "string", "description": "城市名称"}
            },
            "required": ["city"]
        }
    },
    {
        "name": "send_email",
        "description": "发送邮件给指定收件人",
        "parameters": {
            "type": "object",
            "properties": {
                "to": {"type": "string"},
                "subject": {"type": "string"},
                "body": {"type": "string"}
            },
            "required": ["to", "subject", "body"]
        }
    }
]

# ↓ 步骤 2:Agent 自主决策与执行(伪代码)
# 你告诉 Agent:"帮我查一下北京天气,然后发邮件给 boss@company.com"
# Agent 不是一次性回答,而是分两步真正执行:
# 第一步:调用 get_weather(city="北京") -> 得到 "晴天 15°C"
# 第二步:调用 send_email(to="boss@company.com", subject="今日天气", body="北京今天晴天 15°C")
# 每一步都是真实发生的,不是在"假装"
你看这段代码,工具定义里没有一行执行逻辑,只有「名字、描述、需要哪些参数」,本质上就是一份说明书。模型读了这份说明书,自己决定该调哪个工具、参数填什么,然后把决策以 JSON 格式告诉你,真正执行的还是你的代码。这个**「决策和执行分离」的思想,是理解工具调用最核心的一点** 。
理解了工具调用之后,你会发现 Agent 光有「做事」的能力还不够,它还得「记事」。
支柱 2:记忆机制
传统 LLM 每次对话都是「失忆」的,除非你手动传上下文,不然它完全不记得上一次说了什么。而 Agent 系统通常会设计短期记忆 和长期记忆 两层。
短期记忆 :当前任务执行过程中的中间状态,比如第一步搜索到了什么、第二步计算结果是多少,这些都存在上下文里,保证 Agent 不会做到一半忘了前面发生了什么。
长期记忆 :跨任务的记忆,比如用户的偏好、历史操作记录,通常用向量数据库来存储,需要的时候做语义检索拿回来。
有了这两层记忆,Agent 在执行复杂任务时才能保持连贯性,不会走着走着忘了目标是什么。
支柱 3:多步推理和自我纠错
那有了工具能做事、有了记忆能记事,Agent 就完整了吗?还差最后一块拼图,也是 Agent 最像「人」的地方。
Agent 在执行过程中如果某一步失败了,它不会直接崩掉,而是能感知到失败、分析原因、换一种方式重试。比如用关键词 A 搜索没找到有用信息,它会自己换关键词 B 再搜一次;调用某个 API 报错了,它会看报错信息然后调整参数重新调用。
这就像一个真正在「思考」的执行者,碰到障碍会绕路走,而不是一条路走到黑 。更进一步,它还能在完成某一步之后回头审视:我做的这步对不对?结果和预期一致吗?要不要调整后续的计划?
这种「边做边反思」的能力,让 Agent 在面对复杂、不确定的任务时,表现远比死板的自动化流程好得多。
讲完这三件事,我们用一个最直观的场景来感受一下差距。你让一个普通 LLM「帮我发一封天气播报邮件」,它能做的只是告诉你「你可以这样写代码……」;而一个 Agent,它会真的去调天气 API、拿到数据、组织邮件内容、再调邮件发送接口,整个过程自动完成。这就是本质区别:从生成文字,到执行任务 。
Agent 现在才爆发的三个条件
你可能会问,Agent 的概念其实很早就有了,为什么到 2024、2025 年才真正火起来?原因是三个条件在最近几年同时成熟了。
条件 1:大模型能力跨过门槛 。早期的语言模型理解能力有限,你让它做任务拆解、判断下一步该调哪个工具,它根本做不好。但从 GPT-4 / Claude 3 那一代(考点:此后又被 GPT-5.x / Claude 4.x 等接替 )开始,模型的推理能力、指令遵循能力有了质的飞跃,它真的能「读懂」复杂指令并做出合理的多步决策了。
条件 2:工具调用标准化 。OpenAI 在 2023 年推出了 Function Calling 机制,让模型能以结构化的 JSON 格式输出工具调用请求,这个标准很快被各家模型厂商跟进。有了统一的工具调用协议,开发者才能方便地给模型接上各种外部能力,不然每接一个工具都要自己写一套解析逻辑,工程成本太高。
条件 3:配套生态完善 。LangChain、LlamaIndex 这些框架把 Agent 的开发门槛大幅降低了,向量数据库解决了长期记忆的存储问题,各种 API 服务让可调用的工具越来越丰富。三个条件凑齐,Agent 从论文概念变成了工程实践,这才有了现在的爆发。
Agent 生态的最新趋势:MCP 与 A2A
Agent 火起来之后,一个很自然的问题就冒出来了:Agent 越来越多,它们之间怎么协作?工具越来越多,怎么统一管理?这两个问题催生了两个非常重要的标准协议。

MCP:Agent 工具世界的「USB-C 接口」
第一个是 Anthropic 在 2024 年底提出的 MCP(Model Context Protocol,模型上下文协议) 。你可以把 MCP 理解成 Agent 工具世界的「USB-C 接口」。
在没有 MCP 之前,每个 Agent 框架接每个工具都要写一套适配代码,假设有 M 个 Agent 框架和 N 个工具,就需要 M × N 套适配逻辑,工程成本非常高。MCP 的做法是定义一套标准的 JSON-RPC 协议,工具提供方只要按这个标准暴露自己的能力(变成一个 MCP Server),任何支持 MCP 的 Agent(通过内置的 MCP Client)都能直接发现和调用这些工具,不需要额外写适配代码。
MCP 的架构分三层:最外层是 Host (用户直接交互的 AI 应用,比如 Claude Desktop、Cursor 这些),中间是 Client (负责和 MCP Server 建立连接、管理通信),最里层是 Server (真正暴露工具能力的服务)。
2025 年 12 月 Anthropic 把 MCP 正式捐给了 Linux 基金会旗下新成立的 Agentic AI Foundation(AAIF),由 Anthropic、Block、OpenAI 共同创立,Google、Microsoft、AWS、Cloudflare、Bloomberg 等都表示支持,生态发展非常快,目前已经有数千个公开的 MCP Server 可用。
A2A:Agent 间通信协议
第二个是 Google 在 2025 年 4 月推出的 A2A(Agent2Agent,Agent 间通信协议) 。如果说 MCP 解决的是「Agent 怎么调用工具」的问题,A2A 解决的就是「Agent 怎么和另一个 Agent 协作」的问题。
在多 Agent 系统里,不同的 Agent 可能来自不同的厂商、用不同的框架开发,它们之间怎么互相发现对方的能力、怎么协调任务、怎么传递中间结果?A2A 的核心设计是一个叫 Agent Card 的概念,每个 Agent 都有一张「名片」,上面写着它能做什么、正在做什么、需要什么输入,其他 Agent 读了这张名片就知道该怎么跟它协作。
A2A 在 2025 年 6 月被 Google 捐给了 Linux 基金会维护,SAP、Salesforce、ServiceNow 等大厂都在接入。
MCP 与 A2A 的关系
这两个协议的关系其实是互补的:
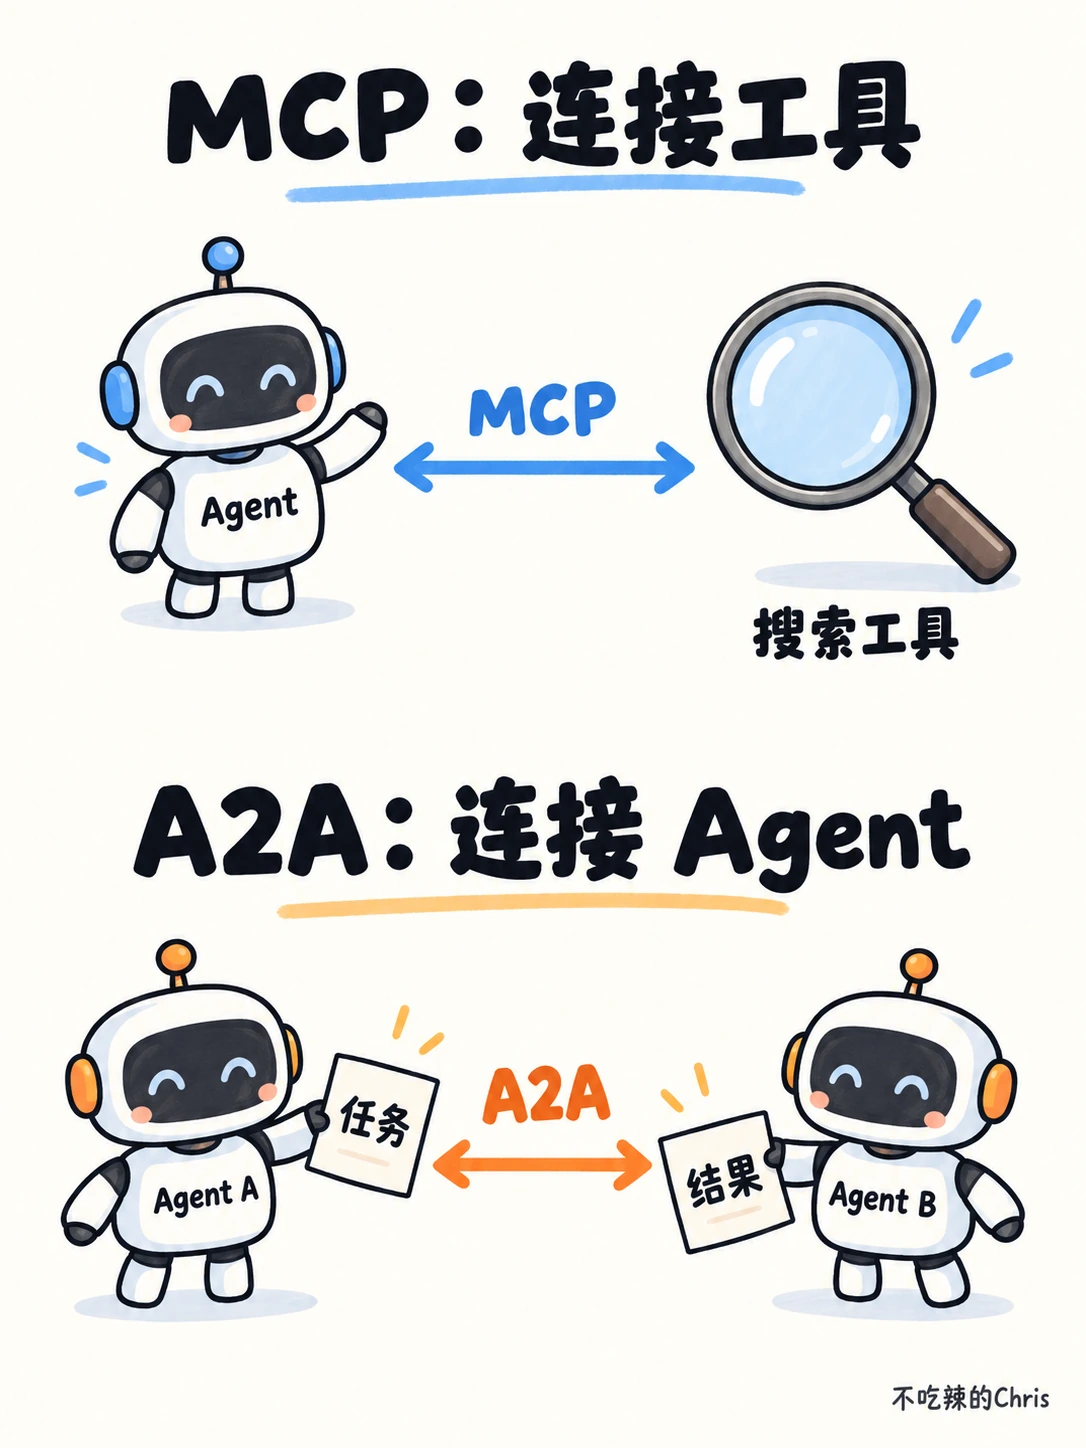
MCP 管的是 Agent 和工具之间的连接(每个 Agent 都能方便地「伸手拿工具」)
A2A 管的是 Agent 和 Agent 之间的通信(不同的 Agent 能方便地「互相说话合作」)
未来的 Agent 生态大概率是两个协议同时存在、各管一层的格局。面试的时候能把这两个协议的定位和区别说清楚,会非常加分 。
哪些情况容易误判为 Agent
踩坑 1:把「能调工具的 LLM」直接等同于 Agent

错误描述 :「ChatGPT 开了搜索功能就是 Agent 了」「我用 Function Calling 调了一个 API 就是 Agent」。
正确做法 :单次工具调用只是 Agent 的一个能力切片,Agent 必须有「自主决策 + 多步执行 + 感知反馈」的闭环 。判断是不是 Agent,看它能不能在不确定的情况下自己决定「下一步该做什么」。一次性调用工具然后返回结果的,最多算「带工具的 LLM」,不是 Agent。
踩坑 2:以为模型自己在执行工具
错误描述 :「Agent 自己去访问网络、查数据库」。
正确做法 :在工具调用环节,模型输出结构化的调用请求 ,真正去访问网络、调 API、跑代码的是宿主程序代码。这个职责分工是整个 Agent 机制的核心设计。面试时一定要点出「模型只做决策,代码做执行 」。
踩坑 3:忽略「闭环」只讲「调工具」

错误描述 :只讲 Agent 能调多少种工具,不讲它怎么根据结果调整后续动作。
正确做法 :必须强调感知 → 规划 → 行动 → 再感知的闭环。Agent 的核心价值在于**「失败能感知、能重新规划」**,这才是它区别于自动化脚本的关键。
踩坑 4:把 Function Calling 和 MCP 搞混
错误描述 :「MCP 不就是另一种 Function Calling 吗?」
正确做法 :Function Calling 是模型提出结构化工具调用请求的机制,MCP 是应用连接外部工具与资料的协议。应用可以通过 MCP 发现工具,把工具说明交给模型,再按模型的调用请求通过 MCP 执行。详见 Q5 MCP 协议。
再往下追问时怎么解释
追问 1:Agent 和 Workflow(工作流)有什么区别? 答题要点:Workflow 是预先编排好的步骤(开发者写死流程),Agent 是 LLM 自主决定步骤(动态规划)。Workflow 可控性强、不灵活;Agent 灵活但不可控。生产中常用「Agent + Workflow 混合」:关键路径用 Workflow 保稳定,开放式任务用 Agent 保灵活。
追问 2:Agent 的「规划能力」具体怎么实现? 答题要点:主流是 ReAct(Reasoning + Acting,让模型边推理边行动)和 Plan-and-Execute(先一次性规划全部步骤再执行)。ReAct 灵活但耗 token;Plan-and-Execute 一次规划好步骤可以并行执行,但中途出错难调整。
追问 3:Agent 的「记忆」具体怎么落地? 答题要点:主要分为三层:短期记忆 :保存当前对话上下文,通常直接放在 Context 中。 工作记忆 :保存 Agent 当前任务过程中的中间状态、计划、工具调用结果等。长期记忆 : 把用户偏好、历史经验、重要事实等持久化到数据库、向量数据库等,需要时检索出来。 核心流程: 用户信息/历史经验 → 提取重要信息 → 存储 → 新任务到来 → 检索相关记忆 → 注入上下文 → Agent 决策。所以,记忆不是模型自己“记住了”,而是 Agent 通过“存储 + 检索 + 上下文注入”实现的。
面试中如何回答
面试回答可以围绕三个容易混淆的点展开。
第一个雷 :把 Agent 等同于「插件」或「工具调用」,这是最常见的误区。工具调用只是 Agent 能力的一部分,不是 Agent 本身。
第二个雷 :停在「能调工具」这一层,没有点出自主性 。Agent 的关键不是「有工具」,而是「自己决定用不用、什么时候用、用哪个」。
第三个雷 :忽略了执行闭环。感知 → 规划 → 行动 → 再感知 这个循环才是 Agent 区别于普通 LLM 的核心机制。
面试时答这道题,一定要点出三件事:
Agent 有自主规划能力 ,给它一个复杂目标它能自己拆解成多步
它能行动 ,通过工具调用跟外部世界真实交互
它有闭环 ,每步的结果会反馈回来指导下一步,而不是一次性生成完就结束
另外还要提一句容易混的点:模型本身只是「大脑」,工具的真正执行是你的代码,模型只负责决策。能补充 MCP 和 A2A 两个协议的定位差异,这道题就稳了。