Appearance
Q51 · 如何在 LangGraph 中实现条件分支和循环?
客服收到“已拆封的商品能自动退款吗”。第一次查到的 FAQ 摘要只说“签收后 7 天内可自动退款”,没有写拆封限制。直接回答可能漏掉改变结论的条件;无止境地重复搜索又会耗时、耗资源。我们希望流程这样运行:查政策 → 检查证据是否完整 → 不完整且还可再查时回到查政策;证据完整就回答;查满约定次数仍不完整就转人工。
LangGraph 用一个共享的 **State(状态)**保存“查了几次、当前片段、来源和结论”;**Node(节点)**读取状态、执行一步工作并返回更新;**Edge(边)**决定下一步走哪。add_conditional_edges 接受一个路由函数,依据更新后的状态选择目标节点或 END。让其中一条边指回先前节点,便构成循环;另一条边通向 END,便有退出路径。官方 Graph API 文档把循环停止条件通常写成指向 END 的条件边,同时说明 StateGraph 需要先编译才能执行。LangGraph Graph API 概览、创建和控制循环
以下政策全是教学假设,不是任何商家的真实规则。现行政策 v3 规定“签收后 7 天内且未拆封可自动退款;已拆封需人工核验”。第一次搜索只返回未核实的 FAQ 摘要;第二次搜索才返回 policy-v3 原文。用户问的是政策规则,示例没有订单权限或订单状态查询,也不会执行退款。真正判断某笔订单还需先核实该订单的签收日和拆封状态。
术语与符号
| 术语或代码 | 直白解释 | 本例对应物 |
|---|---|---|
| Graph / 图 | 有步骤和连接关系的执行流程 | 查政策、检查证据以及返回重查的路线 |
StateGraph | 用状态字段定义节点之间如何共享数据的构建器 | 以 PolicyState 建立售后政策流程 |
| State / 状态 | 当前这次执行已掌握的记录快照 | 问题、次数、片段、来源、状态与答复 |
| Node / 节点 | 接收状态并返回部分字段更新的函数 | search_policy、check_evidence |
| Edge / 边 | 一个节点结束后通往下一节点的连接 | START → search、search → check |
| 条件边 / 路由函数 | 先读当前状态,再从几个去向中选一个 | route_after_check 选重查或结束 |
START / END | 图开始与结束的虚拟标记 | 从 START 进入 search;完成后到 END |
TypedDict | 给 Python 字典字段写出预期类型;本身不做运行时数据校验 | PolicyState 声明七个字段 |
Literal | 表示返回值只预计在列出的几个文本中 | 路由只返回 "again" 或 "finish" |
compile / invoke | 前者把构建器编译成可执行图;后者用一份输入运行图 | 先建图,再处理一条咨询 |
attempts / max_attempts | 已查次数 / 本业务最多允许查的次数 | 0 起步,最多查 2 次 |
snippet / source_id | 当前检索片段 / 可识别其来源的标识 | FAQ 摘要或现行 policy-v3 |
status / answer | 检查后的业务状态 / 给用户的答复 | retry、found、exhausted 之一 |
recursion_limit | 一次图执行允许的最大图步骤数,是运行时保护线 | 用 10 让示例走完;用 2 演示触发上限 |
GraphRecursionError | 图达到步骤上限但还没完成时抛出的异常 | 上限设得过低时由调用方捕获 |
TypedDict 让代码结构更清晰,却不会自动检查外部输入。真实入口要验证 max_attempts 是允许的正整数、问题字段符合预期;真实政策检索还要核对权限、生效时间和来源内容。LangGraph 官方文档说明,节点形式上是“状态 → 部分状态更新”,没有专门的合并规则时,新值会替换该字段的旧值。LangGraph:状态与默认更新规则
图上哪条线会回去,哪条线会结束
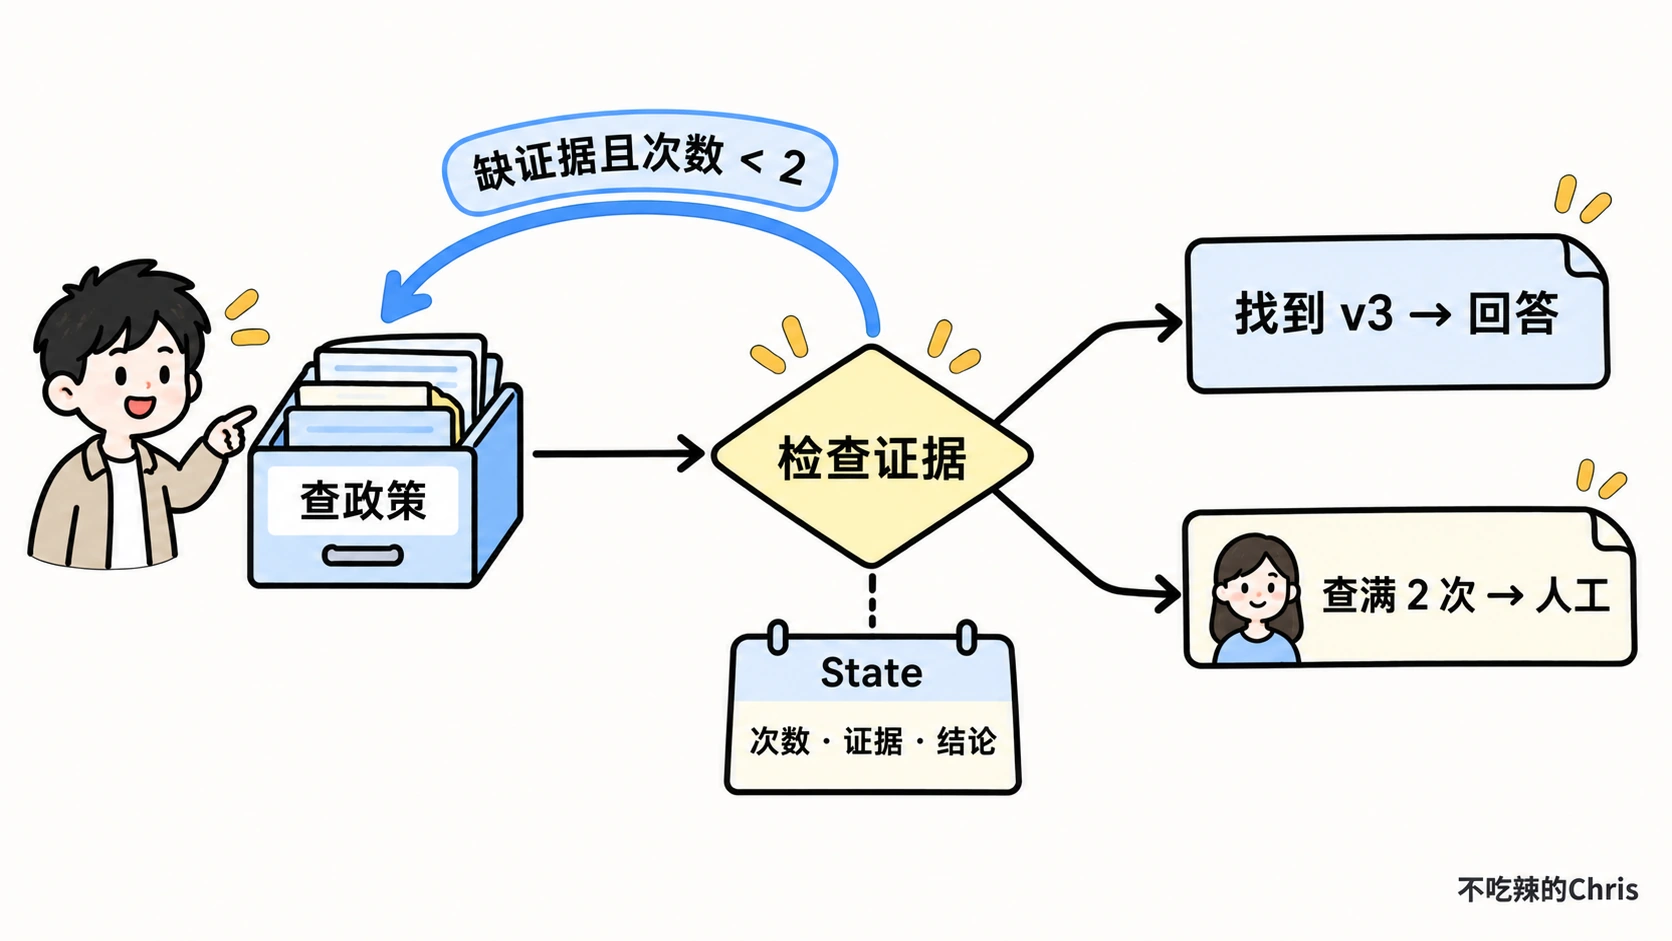
从左向右看,查政策 产生一个带来源的片段,检查证据 判断它能否支撑结论。图中的蓝色回环只在“缺证据且次数 < 2”时返回查政策;右侧上方是已找到现行 v3 后回答,下方是查满 2 次仍不足时转人工。底下的 State 小卡片提醒:判断依据来自已更新的次数、证据和结论。图把真实代码里的“检查节点更新状态”与“条件边选择去向”合在一处画,具体职责在下文拆开。
普通边适合固定顺序:从 search 结束后始终到 check。条件边适合可变去向:从 check 结束后要么回 search,要么去 END。这里不要再从 check 额外加一条普通边到 END,以为它只是“默认路径”;LangGraph 文档指出同一节点的多条出边可能使多个目标都被执行。一个分叉点选一种清楚的路由方式,结果更容易预测。LangGraph:Edges
先确定状态如何变化
本例的状态只有七个字段。输入时 attempts=0、status="new",尚无 snippet。search_policy 每次执行只更新 attempts、snippet、source_id;check_evidence 只更新 status 和 answer;路由函数只读 status,不负责修改状态。
| 时点 | attempts | snippet 和 source_id | status | 下一步 |
|---|---|---|---|---|
| 刚进入图 | 0 | 都为空 | new | 查政策 |
| 第一次查询后 | 1 | FAQ 摘要 / faq-summary,缺拆封例外 | 检查后是 retry | 条件边回到查政策 |
| 第二次查询后 | 2 | 完整 v3 条款 / policy-v3 | 检查后是 found | 条件边到 END |
另一个问题“赠品能自动退款吗”在这个有限的假数据源中两次都查不到可核实的现行条款。第一次检查后是 retry,第二次检查后是 exhausted,于是到 END 并给出“请人工核实”。exhausted 表示已经到达业务查询上限但证据不足,不能改写成“政策禁止退款”。
可直接运行的完整代码
下面的 search_policy 是内存中的假检索器:第一轮故意只给 FAQ 摘要,第二轮才给完整的 v3 条款。这样无需模型密钥或网络服务就能观察回环。示例已使用 Python 3.14 和 langgraph==1.2.12 实际运行;可先执行 python -m pip install 'langgraph==1.2.12',再把以下代码保存为 q51.py 运行。项目依赖版本应自行锁定并验证。LangGraph Graph API
在代码中,PolicyState 列出七个状态字段;state 是节点本次读到的状态;next_attempt 是本次查询后的次数;verified 是“来源为 policy-v3 且包含拆封限制”的检查结果。builder 只负责连线,graph 才是编译后可执行的对象;initial 为每次咨询创建独立初始状态,避免沿用上一笔咨询的次数。
python
from typing import Literal, TypedDict

from langgraph.errors import GraphRecursionError
from langgraph.graph import END, START, StateGraph


class PolicyState(TypedDict):
    question: str
    attempts: int
    max_attempts: int
    snippet: str
    source_id: str
    status: str
    answer: str


def search_policy(state: PolicyState) -> dict:
    next_attempt = state["attempts"] + 1
    if state["question"] == "已拆封能自动退款吗?" and next_attempt == 1:
        snippet = "FAQ 摘要:签收后 7 天内可自动退款。"
        source_id = "faq-summary"
    elif state["question"] == "已拆封能自动退款吗?" and next_attempt == 2:
        snippet = "政策 v3:签收后 7 天内且未拆封可自动退款;已拆封需人工核验。"
        source_id = "policy-v3"
    else:
        snippet = ""
        source_id = ""
    return {
        "attempts": next_attempt,
        "snippet": snippet,
        "source_id": source_id,
    }


def check_evidence(state: PolicyState) -> dict:
    verified = (
        state["source_id"] == "policy-v3"
        and "已拆封需人工核验" in state["snippet"]
    )
    if verified:
        return {
            "status": "found",
            "answer": "按政策 v3,已拆封需人工核验,不能直接自动退款。",
        }
    if state["attempts"] >= state["max_attempts"]:
        return {
            "status": "exhausted",
            "answer": "两次未查到可核实的现行条款,请人工核实。",
        }
    return {"status": "retry", "answer": ""}


def route_after_check(state: PolicyState) -> Literal["again", "finish"]:
    return "again" if state["status"] == "retry" else "finish"


builder = StateGraph(PolicyState)
builder.add_node("search", search_policy)
builder.add_node("check", check_evidence)
builder.add_edge(START, "search")
builder.add_edge("search", "check")
builder.add_conditional_edges(
    "check", route_after_check, {"again": "search", "finish": END}
)
graph = builder.compile()


def initial(question: str) -> PolicyState:
    return {
        "question": question,
        "attempts": 0,
        "max_attempts": 2,
        "snippet": "",
        "source_id": "",
        "status": "new",
        "answer": "",
    }


normal = graph.invoke(initial("已拆封能自动退款吗?"), config={"recursion_limit": 10})
print(normal["status"], normal["attempts"], normal["answer"])

missing = graph.invoke(initial("赠品能自动退款吗?"), config={"recursion_limit": 10})
print(missing["status"], missing["attempts"], missing["answer"])

try:
    graph.invoke(initial("已拆封能自动退款吗?"), config={"recursion_limit": 2})
except GraphRecursionError:
    print("GraphRecursionError:图步骤上限先于业务结论触发")
实际输出:
text
found 2 按政策 v3,已拆封需人工核验,不能直接自动退款。
exhausted 2 两次未查到可核实的现行条款,请人工核实。
GraphRecursionError:图步骤上限先于业务结论触发
add_conditional_edges("check", route_after_check, {"again": "search", "finish": END}) 的三个参数分别是:从哪个节点分叉、调用哪个函数得到分支标签、标签对应哪个目的地。route_after_check 读取 check_evidence 写入的新 status;若为 retry 则返回 again,映射回 search;若为 found 或 exhausted 则返回 finish,映射到 END。提供这份映射也让图的可达路径清楚。LangGraph:add_conditional_edges API
代码对完整证据的检查非常简化,只识别假数据中的来源 ID 和关键短语。生产系统还需验证来源真实性、生效日期、权限、条款上下文以及是否存在其他例外。更不能让网页或工具返回的文字决定是否绕过 max_attempts。同一循环可把第二次搜索改成扩大查询或换可信数据源,而不是把同一个输入重复发送两遍;否则次数虽然增加,证据未必变多。
两道上限各管什么
业务次数上限是 max_attempts=2:由节点更新 attempts,并在检查证据时决定是否转人工。它表达“这类咨询最多查两次”的产品规则,因此能在正常路径里返回明确的 exhausted。attempts 只在真正执行 search_policy 时加 1;check_evidence 和路由函数不会加它。
图步骤上限是运行参数 recursion_limit:限制一次图执行可经历的 **super-step(图执行轮次)**数量,达到上限而未正常结束时抛 GraphRecursionError。它不是“允许搜索几次”,因为一次搜索还要经过检查节点;节点结构、并发分支都会影响图步骤数。也不要把它与 Python 函数递归深度混为一谈。官方文档明确把 recursion_limit 放在 config 顶层,如 config={"recursion_limit": 10},并把它描述为图轮次的保护机制。LangGraph:Graph API 的 Recursion limit、GraphRecursionError 参考
因此正常运行时要把图步骤上限设得足以覆盖业务允许的路径,让业务终止条件先发挥作用。代码中的 10 是为了跑完“搜索、检查、再搜索、再检查”示例而设,不是对所有图的推荐值;2 则故意过低,用来演示异常。捕获异常后,调用方应记录本次执行失败并告知“流程未完成”,不能把未返回的中间片段当作最终政策答复。若流程需要在接近图上限前优雅收尾,官方文档还介绍了 RemainingSteps 等提前感知剩余步骤的方法。LangGraph:访问和处理递归计数器
实际系统还应给单次检索加超时、限制总耗时和费用,记录每轮的查询词、来源、结果与路由原因。若外部检索超时,节点可按业务规则给出“资料不可用”状态并结束,或只对可安全重试的读取请求尝试有限重试;不能把超时伪装成“政策不存在”。如果需要跨请求暂停恢复,才引入检查点等持久化机制,详见 Q50。这些工程约束与 recursion_limit 是不同层次的控制。
面试时可以这样回答
我先定义 State,把问题、证据、来源、已尝试次数和处理状态放进去。查询节点只负责取资料并返回部分状态更新;检查节点判定证据够不够、是否已经达到业务次数上限。固定顺序用
add_edge,需要选择下一步时用add_conditional_edges:证据不足且次数未满就指回查询节点,证据充分或次数已满就去END,分别给出有依据的回答或人工核实。图还设置recursion_limit作为意外死循环的图步骤保险线,但它不是业务重试次数;正常停止应由状态里的明确条件实现。我会分别验证找到证据、查满仍缺证据和图步骤超限的路径,并记录每轮来源与路由原因。
如果追问“为什么有 recursion_limit 还要自己计数”,回答是:前者数图轮次,耗尽会抛异常;后者数业务查询,能主动走到 exhausted 并给用户明确结果。如果追问“条件函数能否直接改状态”,本例把状态更新放在 check_evidence 节点,让路由函数只读状态;这样每轮检查结果与下一步选择更容易单独核对。