Appearance
Q48 · LCEL 的 | 管道符背后是什么原理?
客服要回答“订单 A123 能自动退款吗”。程序先整理订单号,再查订单和现行政策,最后依据两份数据判断资格。假设我们已经把这些动作写成独立步骤,想用一行代码表示它们的连接:整理输入 | 查订单与政策 | 判断资格。这里的 | 究竟是在拼字符串、立刻执行步骤,还是在安排以后怎样执行?
在 LangChain 的 LCEL(LangChain Expression Language,表达式语言)中,| 是把可运行组件 Runnable 接成一条固定顺序的路径。Python 允许类重新定义 | 的含义;LangChain 利用这个能力构造 RunnableSequence。构造时先得到“执行计划”对象;调用它的 invoke 等方法时,才把真实输入交给第一步,并将每一步的输出交给下一步。官方参考文档明确将 RunnableSequence 定义为这种逐步传值的组合,并给出 runnable_1 | runnable_2 的示例。LangChain:RunnableSequence
本篇专注于管道符的机制。关于“Chain 与 LCEL 是什么关系”,可先看 Q46。下文的退款政策是教学假设:查询日为 2026 年 9 月 25 日,A123 于 9 月 20 日签收且已拆封;政策 v3 从 9 月 1 日生效,规定“签收后 7 天内且未拆封可自动退款,已拆封需人工核验”。因此示例的结果是“不能自动退款,需人工核验”,代码也不会执行退款。
术语与符号
| 术语或代码 | 零基础解释 | A123 例子里的对应物 |
|---|---|---|
| LCEL | 用组合写法描述 Runnable 怎样连接 | 把整理、查询、判断接成处理路径 |
| Runnable | 有统一调用方法的一个处理步骤,也可以是一整条已组合的路径 | 整理输入、查订单、判断资格 |
| ` | ` | Python 的一个运算符;对于 Runnable,LangChain 赋予它“组合步骤”的含义 |
运算符重载、__or__ | 类定义遇到左操作数 ` | ` 时怎样处理 |
__ror__ | 左侧类型不处理时,Python 可尝试右侧对象的反向方法 | 让部分可转换对象也能参与组合;本例不用它 |
RunnableSequence | 顺序组合对象:第一步输出作为第二步输入 | 整理 → 查询 → 判断 |
RunnableParallel | 把同一输入交给多个分支,并将分支结果汇成字典 | 同时查订单与政策 |
RunnableLambda | 把普通 Python 函数包装成 Runnable | 把 normalize 等函数接入路径 |
invoke / ainvoke | 对一个输入执行;后者是异步调用 | 用 A123 的问题数据运行一次 |
batch / abatch | 对一批输入执行;后者是异步版本 | 处理多笔订单咨询 |
stream / astream | 以迭代方式取得一个输入的输出;能否逐块早到由组件决定 | 可能只在最终判断完成后给一块结果 |
| 输入输出契约 | 相邻步骤约定传什么数据形状与字段 | 查询步骤需收到 order_id 和 today |
| 异常 | 执行出错时抛出的信号,通常会让调用者收到失败 | 查不到订单时抛 LookupError |
Runnable 是接口层面的共同约定:可调用、可组合,通常也提供批量和流式方法。有方法名并不保证某个组件真正能逐字输出,也不保证业务字段一定匹配。官方 Runnable 参考把 RunnableSequence(顺序)与 RunnableParallel(并行分支)列为不同组合原语。LangChain:Runnable 与组合
写下 | 时,Python 和 LangChain 各做了什么
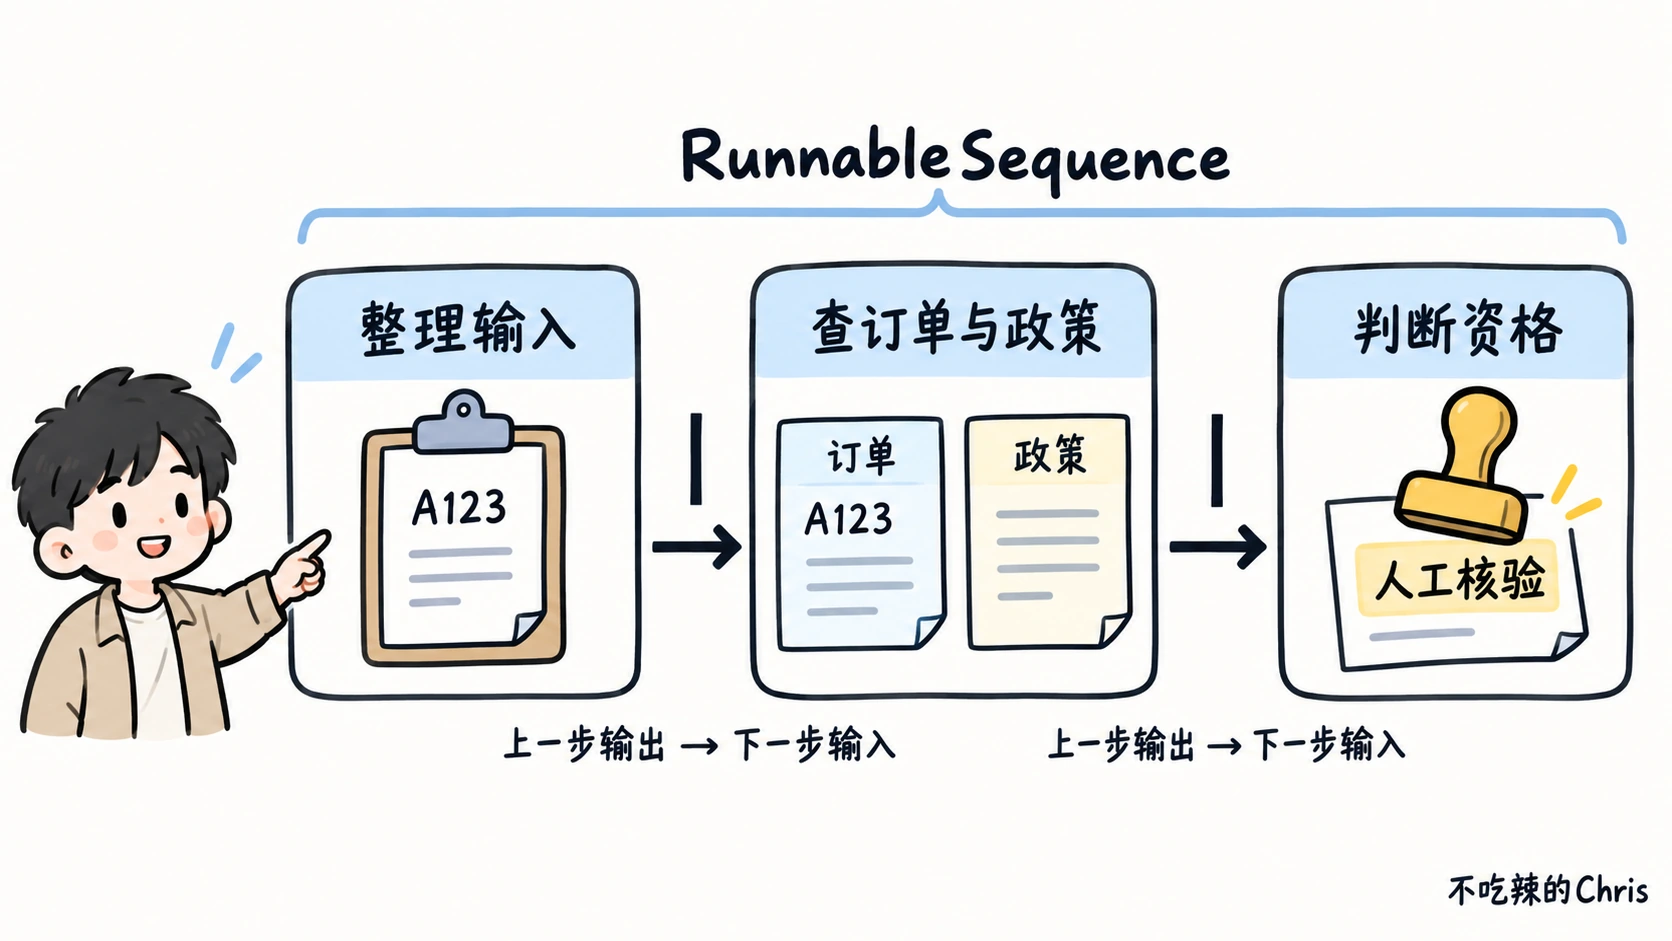
图从左往右读:第一站整理 A123,第二站取得订单与政策,第三站给出“人工核验”。卡片之间的 | 表示组合关系;箭头表示执行时的数据方向。图中的第二站内部可以并行查两份独立资料,但第一站、第二站、第三站的总体先后关系仍固定。
Python 原本把 | 用于按位或等操作;对自定义类,解释器可调用左侧对象的 __or__ 方法,必要时按语言规则尝试右侧的 __ror__。LangChain 在 Runnable 类上实现组合逻辑。下面是帮助理解的示意写法,不是独立可运行代码:
text
first | second       # 构造顺序组合对象
# 等价理解:RunnableSequence(first=first, last=second)这里的“等价理解”说的是运行效果和组合类型,不是让读者手写 LangChain 的内部源码。first | second | third 按 Python 的表达式规则从左向右组合,得到可再次充当 Runnable 的组合对象。单单构造它不会查询订单,也不会调用模型;执行开始于 sequence.invoke(input)、stream(input) 等调用。Python 的运算符数据模型说明了 __or__ / __ror__ 的分派规则;LangChain 的 pipe 方法文档也将 .pipe(next) 与 | next、RunnableSequence 对应起来。Python 数据模型、LangChain:Runnable.pipe
执行时,RunnableSequence 先调用第一步,再将第一步实际返回值送给第二步。这意味着接口是否接得上,要看数据形状:若第一步返回 "A123" 字符串,第二步却写 data["order_id"],运行时会出错。| 不会替你补字段、转换任意类型或核验政策真假。给函数加类型标注、检查输入、单测每个边界,才能把这种契约写清楚。
一段无需模型密钥的完整示例
为看清传值过程,代码用内存里的假订单和假政策,不接真实模型或后台。示例已用 Python 3.14 与 langchain-core==1.6.5 运行核对;可用 python -m pip install 'langchain-core==1.6.5' 安装后保存为 q48.py 执行。langchain-core 的版本会演进,项目应锁定并测试自己的依赖版本。
运行入口数据是 {"order_id": " a123 ", "today": "2026-09-25"}。order_id 是带空格和小写的订单号;today 是查询日期的 ISO 格式文本。normalize 把它们变成可查询的形式;load_order 和 load_policy 用同一份整理后输入各取一份数据;decide 根据两份结果判断。下面的 request 指整理后的请求字典,evidence 指两个查询分支合并后的字典,days 指签收以来的天数,eligible 指是否符合本例自动退款条件。
python
from datetime import date

from langchain_core.runnables import (
    RunnableLambda,
    RunnableParallel,
    RunnableSequence,
)


def normalize(payload: dict) -> dict:
    order_id = payload["order_id"].strip().upper()
    if not order_id:
        raise ValueError("订单号不能为空")
    return {
        "order_id": order_id,
        "today": date.fromisoformat(payload["today"]),
    }


def load_order(request: dict) -> dict:
    if request["order_id"] != "A123":
        raise LookupError("示例数据中没有这笔订单")
    return {
        "order_id": "A123",
        "signed_on": date(2026, 9, 20),
        "opened": True,
        "today": request["today"],
    }


def load_policy(request: dict) -> dict:
    if request["today"] < date(2026, 9, 1):
        raise ValueError("示例政策 v3 当时尚未生效")
    return {
        "version": "v3",
        "max_days": 7,
        "requires_unopened": True,
    }


def decide(evidence: dict) -> dict:
    order = evidence["order"]
    policy = evidence["policy"]
    days = (order["today"] - order["signed_on"]).days
    if days < 0:
        raise ValueError("查询日期早于签收日期")
    eligible = days <= policy["max_days"] and (
        not policy["requires_unopened"] or not order["opened"]
    )
    return {
        "order_id": order["order_id"],
        "eligible": eligible,
        "answer": "符合示例自动退款条件" if eligible else "不能自动退款,需人工核验",
        "policy": policy["version"],
    }


sequence = (
    RunnableLambda(normalize)
    | RunnableParallel(
        order=RunnableLambda(load_order),
        policy=RunnableLambda(load_policy),
    )
    | RunnableLambda(decide)
)

request_data = {"order_id": " a123 ", "today": "2026-09-25"}
assert isinstance(sequence, RunnableSequence)
print(sequence.invoke(request_data))

try:
    sequence.invoke({"order_id": "A999", "today": "2026-09-25"})
except LookupError as error:
    print(type(error).__name__, str(error))
输出为:
text
{'order_id': 'A123', 'eligible': False, 'answer': '不能自动退款,需人工核验', 'policy': 'v3'}
LookupError 示例数据中没有这笔订单
跟着 A123 走一遍:normalize 把 " a123 " 整成 "A123",把日期文本解析为日期对象;中间的 RunnableParallel 给两个分支相同的 {"order_id": "A123", "today": 日期}。load_order 返回签收日、已拆封和查询日;load_policy 返回 v3、7 天与“必须未拆封”。分支结果被汇成 {"order": 订单字典, "policy": 政策字典},因此 decide 能按 evidence["order"] 和 evidence["policy"] 取值。签收后经过 5 天,满足期限,却因已拆封不符合“且未拆封”,所以 eligible=False。
注意第二次调用 A999:它会执行整理和两个查询分支,订单分支抛出 LookupError,判断步骤不会得到完整证据,也不会生成资格结论。因为两个查询分支可能同时运行,政策分支可能已经做过工作;若改成有副作用的真实操作,不能假定异常会自动撤销另一个分支。示例对外部系统没有写操作。LangChain:RunnableParallel
并发、流式和错误的准确边界
| 能力 | | 与序列实际提供什么 | 容易误会的地方 | |---|---|---| | 顺序 | 外层按整理 → 查询 → 判断传值 | | 本身不会使相邻步骤同时执行 | | 并发分支 | 中间显式使用 RunnableParallel,同一输入分发给订单与政策分支 | 只有独立步骤才适合并发;判断仍需等待两份结果 | | 批量 | sequence.batch([输入1, 输入2]) 可处理多笔请求;序列对每一层调用相应批量方法 | 跨不同输入的并发不等于单笔订单内部各步骤并发;真实速度取决于组件、I/O、限流和配置 | | 流式 | stream / astream 暴露流式接口;组件支持分块传递时,下游可更早收到块 | 本例首尾是 RunnableLambda,默认不支持 transform 分块转换,因此不能期望边查边吐出资格结论 | | 错误 | 步骤报错通常中断当前调用并把异常交给调用者 | | 不会自动重试、跳过、回滚或改答“可以退款” |
LangChain 参考文档特别说明:RunnableSequence 的 batch / abatch 会逐层批量调用,默认实现可用线程池或异步机制提高 I/O 密集型工作负载效率;RunnableParallel 才表示一份输入分到多个并发分支。串接两个 Runnable 与并发运行它们是两件事。LangChain:RunnableSequence、LangChain:RunnableParallel
流式也要看各段实现。官方说明只有各组件都能用 transform 逐块转换时,整个序列才能一路传块;如果某一段不能,输出要等到那一段处理完成后才继续流动。官方特别提醒 RunnableLambda 默认没有 transform。因此 list(sequence.stream(request_data)) 在这个示例里会在完整计算后得到一块最终字典,即使方法名叫 stream,也不是逐字显示的模型输出。若需要持续加工流式块,应使用支持该行为的组件或按官方文档实现流式转换。LangChain:RunnableSequence 的流式说明、LangChain:RunnableLambda
异常同样不会被 | 自行修复。输入漏掉 today 时,normalize 读取字典键会报错;订单查不到时,load_order 报错;政策版本不适用时,load_policy 报错。调用方应区分用户数据错误、资料不可用与临时网络失败,并决定是提示补信息、停止判断还是对可安全重试的读取步骤加限定次数的重试。LangChain 提供显式的 .with_retry() 和 .with_fallbacks() 包装器,但应有意识地加在合适的步骤上;整条链盲目重试可能重复外部调用。LangChain:with_retry、LangChain:with_fallbacks
这个内存示例没有认证、权限、超时、真实政策版本查询或资金操作。接实际订单服务时,应用必须验证用户能否查看该订单、检查政策生效范围,对调用设置超时和监控;“符合条件”与“执行退款”应分开。LCEL 管道负责组合与调用步骤,不替业务保证这些约束。
面试时可以这样回答
LCEL 的
|利用 Python 运算符重载,把 Runnable 组合成RunnableSequence。写下a | b | c时主要是在构造一条可调用的路径;调用invoke后,才按顺序把a的输出作为b的输入,再交给c,所以每个边界都要检查数据形状。普通管道符并不自动并行;同一输入的并发分支要显式用RunnableParallel。组合对象有批量、异步和流式接口,但批量速度与流式首块时间取决于各组件实现,尤其RunnableLambda默认会阻断逐块传递。某步抛异常时不会自动重试或回滚,需要在合适的步骤上配置错误处理。
如果追问“| 和 Linux 命令行管道是否一样”,可以说它们都让人联想到“前一段输出交给后一段”,但这里执行的是 Python 对象的运算符方法,传递的可以是字典、日期、消息对象等,并不限定为字节流。如果追问“为什么 sequence.stream() 仍可能一次只给最终结果”,就说明 Runnable 有流式接口,但中间任一不支持逐块转换的组件都可能让这条路径先等待;本例的 RunnableLambda 就是这种情况。