Appearance
Q11 · 什么是 Self-Consistency?它相比 CoT 解决了什么问题?
假设你让模型算一笔库存:“原有 24 个苹果,卖出 9 个,又买入 6 个,还剩多少个?”模型即使写出一串看似完整的步骤,也可能把“卖出”当成“买入”,算出 24+9+6=39。如果应用只取这一次回答,写了步骤仍会把错误结果交给用户。
Self-Consistency(自一致性)让模型对同一道题生成多条推理路径,再统计这些路径给出的最终答案,选择出现最多的答案。 它主要缓解单条思维链偶然走错、却被直接采用的问题。它不能证明多数答案正确,也不能修复题目资料本身的错误。原论文将它作为一种在思维链提示之上的解码策略提出:改变生成和选答案的方法,无须因此重新训练一个模型。
先认清术语与符号
| 词或记号 | 在本文中的意思 | 苹果题中的对应物 |
|---|---|---|
| 大模型 / LLM | 根据输入逐步生成文字的语言模型 | 阅读题目并写出计算过程的程序 |
| Prompt(提示词) | 交给模型的题目与作答要求 | “请列出计算步骤,最后单独写出答案” |
| CoT(Chain of Thought,思维链) | 在最终答案前生成一系列中间推理步骤 | 先算 24−9=15,再算 15+6=21 |
| 推理路径 | 一次生成中,从理解题意到得出答案的完整步骤 | “先扣卖出,再加买入”或“先算净变化” |
| 解码 | 模型把下一步文字逐个生成出来的过程 | 逐字生成算式和结论 |
| 贪心解码 | 每一步倾向选当前最可能的下一个文字,通常只得到一条路径 | 只写出一次计算过程 |
| 采样 | 按生成概率引入随机性,多次运行得到可能不同的路径 | 同题生成 A、B、C 三次 |
温度 / temperature | 一种控制采样随机程度的参数;具体取值和效果依模型接口而异 | 给生成过程留出不同写法的机会 |
| 最终答案 | 从一条路径中提取、用于比较的结果 | 21 或 39 |
| 聚合 / 投票 | 把相同的最终答案归为一组并计数 | 21 两票、39 一票 |
m | 采样的路径条数,不是模型数量 | 图中的 m=3 |
这里的“自”指同一个模型可以多次作答;“一致”指多条路径的最终答案相同,不要求每一步措辞相同。三次采样使用同一题目和作答要求,但生成结果仍可能高度相似,并不意味着三位真正独立的审题者给了意见。
CoT 为什么还会给出错误答案
CoT 原论文研究的是:在提示中给出带中间步骤的例子,引导模型先生成推理步骤,再给答案。对多步算术等任务,这常比只要求一个答案有效。可是,“能写步骤”和“步骤必定正确”是两回事。
在苹果题里,正确步骤可以是 24−9=15,15+6=21。一条错误路径也可以写得很流畅:“卖出 9 个,买入 6 个,所以加上 9+6,得 39 个。”错误并没有因为它被拆成几句话就自动暴露。如果单路径 CoT 恰好生成这条路,最终答案就是 39。原论文比较的典型基线,是 CoT 提示加单条贪心解码路径;Self-Consistency保留 CoT 的“生成步骤”,但不把第一次路径当成唯一候选。论文的方法说明
比较时要分清维度:CoT 回答的是“作答时要不要展示中间步骤”;Self-Consistency 回答的是“有了步骤后,要生成几条、怎样选最终答案”。两者可以叠加,不是要求把 CoT 提示删掉。也不能说所有 CoT 实现都只能生成一条路径;“单路径”是这里讨论的基线设置。
同一道题怎样走完三次采样
图中只有一份题目。模型对它作答三次,应用分别保存每次的步骤和末尾答案:
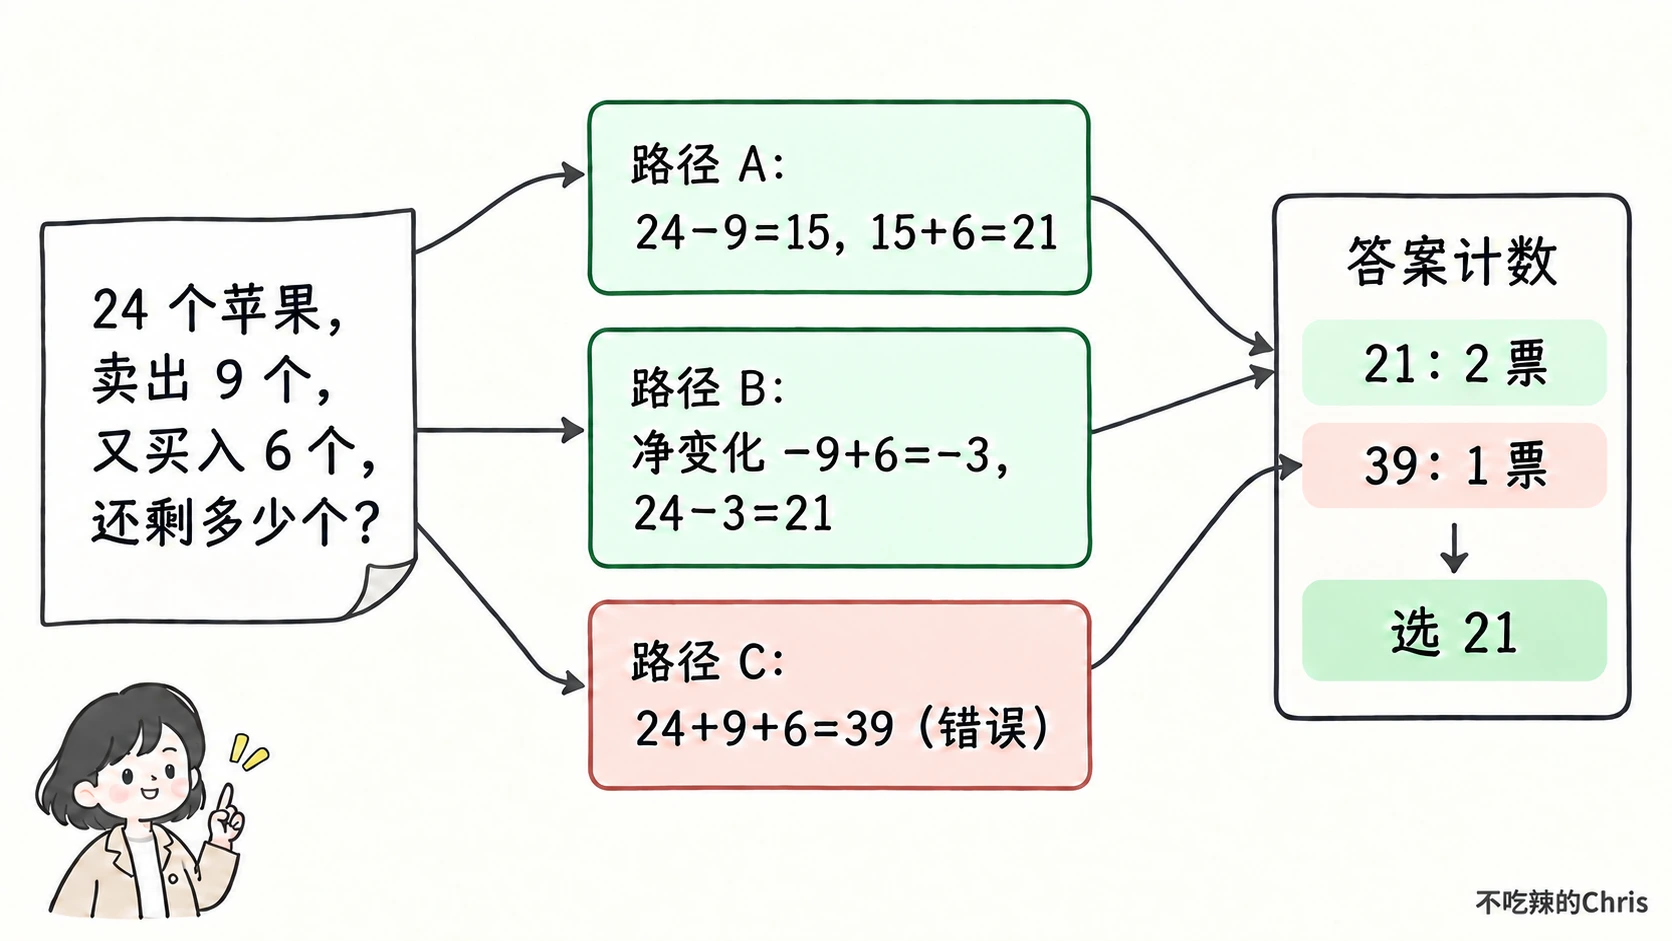
这张图是人为设计的机制示例,不是某个模型的真实实验输出。路径 A 先减后加,得到 21;路径 B 先算净变化 −9+6=−3,再算 24−3=21;路径 C 错把卖出的 9 个也加回去,得到 39。A 与 B 的步骤不同,末尾却都等于 21。
程序随后只拿最终答案计数:21 出现两次,39 出现一次,所以在这一组样本里选 21。票数不是对每一步的逐句裁判,也不是“让三个模型互相讨论”。如果图中的三条路径全都误读了“卖出”,它们可能一致投出 39;一致只说明本次样本达成相同结论。
完整流转可以拆成四步:
- 固定题目和输出约定。 例如要求每条回答最后有单独的
答案:数字,便于程序提取。不要让一次调用的题目比另一次多一条关键信息。 - 生成
m条路径。 对同一模型进行多次带随机性的生成,保存每条“步骤 + 最终答案”。论文使用温度采样等方式获得多样路径;调高温度不等于一定更好,模型接口也可能没有相同的控制方式。论文的采样设置 - 提取和规范答案。 对数字题,
21、21 个、二十一个若确实同义,应映射到同一结果;不能把21与21.5粗暴合并。若无法可靠提取,标为无效样本并记录原因,而不是猜一个数字。 - 按规范后的答案计数。 选出现次数最多的答案;票数相同时不擅自宣布获胜,可补采样或交给核验器。图里的
2/3是真正的过半;若四条路径分别给21、21、39、42,21只是“得票最多”,没有过半。论文使用的计数规则实质上是选最高票答案,中文说“多数投票”时不应误解成每次都存在超过半数的赢家。论文的聚合公式
论文把第三、四步称为对路径“边缘化”:最终比较答案时,把不同路径的细节折叠进每个答案的计数。对初学者来说,先理解“路径不必相同,只比较它们落到哪个答案”就够了。研究还比较了按生成概率加权等聚合办法;本文讲的是最容易实现和解释的无权计数版本。论文的聚合实验
一段只演示计数的代码
下面的 paths 是三条已经生成并提取完答案的示例记录,每条记录的 steps 是步骤、answer 是规范后的最终答案。Counter 是 Python 标准库中计数的工具;votes 是“答案 → 票数”的表;ranked 是按票数从高到低排好的结果。代码没有调用大模型,也没有校验计算步骤,所以只能演示聚合逻辑。
python
from collections import Counter

paths = [
    {"steps": "24-9=15;15+6=21", "answer": "21"},
    {"steps": "-9+6=-3;24-3=21", "answer": "21"},
    {"steps": "24+9+6=39", "answer": "39"},
]

votes = Counter(path["answer"] for path in paths)
ranked = votes.most_common()
if not ranked or (len(ranked) > 1 and ranked[0][1] == ranked[1][1]):
    print("答案未决,需要补采样或核验")
else:
    print(f"选 {ranked[0][0]};票数 {ranked[0][1]}/{len(paths)}")
这里 Counter 得到 {"21": 2, "39": 1},因此输出 选 21;票数 2/3。若把第二条的 answer 改成 39、再删掉第三条,两边各一票,代码就输出“答案未决”。真实系统还要处理接口超时、空答案、格式错误、重复采样和预算上限;不能把这段聚合演示当作完整的生产实现。
它适合什么题,代价是什么
适合的任务通常有可比较的最终答案,而且生成多种步骤有机会纠正单次偶然失误。例如算术题、规则明确的选择题、结论有限的常识推理题。开放写作的“哪篇文案最好”、多个方案都合理的架构设计,往往无法把最终答案简单归一后投票;此时需要明确的评价准则、人工评审或其他方法。
它直接增加推理时计算量:原来只生成一条路径,现在生成 m 条,模型生成的总文本与费用通常随路径数上升。并行请求可能减少等待时间,但不会让计算和计费消失;如果答案提取还要额外调用模型,成本会再增加。论文指出实际可先尝试约 5 或 10 条路径,并观察收益是否趋于饱和,而不必默认采样越多越好。论文的讨论
落地时可先在有标准答案的评测集上比较单路径 CoT 与不同 m 值:同时记录正确率、平均费用、延迟、无法解析答案的比例和投票分歧。根据真实任务选预算,而不是照搬某篇论文中的温度或路径数。论文报告的 GSM8K 等数据集提升是特定模型、提示和评测条件下的结果,不能当成所有模型上线后的保底收益。论文摘要与实验结果
多数同意仍然会错
共同误读。 假设题目缺了“买入的是苹果还是橘子”,多次采样都可能自行补成苹果;票数再高也不能弥补缺失事实。若库存数字来自错误数据库,多条路径都会在同一错误输入上计算。先补资料或核验来源,再谈采样。
系统性偏差与相关样本。 同一模型、同一提示可能反复犯同类错误。即便设置了随机采样,路径也不等同于独立专家意见;看到 9/10 同意,不能把它直接解释成“90% 正确概率”。论文确实发现样本一致程度与某些基准上的准确率相关,但那是经验现象,需要在自己的任务上校准。论文的相关性观察
答案形式和歧义。 0.5 与 1/2 可以表示同一个值,但“可退”“可申请退货”和“已批准退款”不是同一个业务状态。数字、单位、选项字母或业务结论都要按任务写清归一规则。若题目本来允许多个正确答案,只按字符串投票会把合理答案错误地拆开或合并。
答案被选中不代表路径可信。 苹果题的 21 可以由正确步骤得到,也可能由两处错误碰巧抵消得到。Self-Consistency主要在答案层选结果,不负责逐句证明推理真实、工具调用正确或业务规则合规。涉及支付、医疗、法律等高风险决定,应另用确定性规则、可追溯证据和人工复核;票数不能替代这些检查。
面试时怎样回答
可以这样说:“CoT 让模型把中间步骤写出来,但只生成一条路径时,这条路径一旦误读或算错,答案也会错。Self-Consistency在相同的 CoT 题目上采样多条推理路径,提取各自最终答案,按相同答案的出现次数聚合,选择票数最高者。它利用不同正确路径可能收敛到同一答案的现象,改善单次生成的偶然性;代价是更多推理计算。多数票不是正确性保证,特别是输入错误、样本高度相似或答案无法可靠归一时,还要做独立核验。”
如果追问“为什么不直接让模型重想一次”,回答是:重想一次仍只留下一个最终候选;Self-Consistency要保留多条候选并显式比较答案。如果追问“票数相同怎么办”,回答是:先承认当前没有稳定赢家,再按预算补采样,或用计算器、业务规则、检索证据、人工审核核验;不能悄悄取第一条。若追问“是不是训练方法”,回答是:原方法是推理时的采样和聚合策略,不要求为此训练新模型。
资料
- Xuezhi Wang 等,Self-Consistency Improves Chain of Thought Reasoning in Language Models,ICLR 2023。方法、投票公式、采样设置、实验与计算代价见论文全文。
- Jason Wei 等,Chain-of-Thought Prompting Elicits Reasoning in Large Language Models,NeurIPS 2022。用于核对 CoT 提示的原始定义与适用任务。