Appearance
Q98 · 工具调用准确率(Tool Usage Accuracy)到底在测什么?
客服智能体收到“查一下我自己的订单 O-314 到哪了”。它可能答得非常流畅:“您的订单已发货。”可它若根本没查订单系统,这句话就没有依据。另一种情况是它确实调用了查订单工具,却把订单号写成 O-341;工具运行成功,返回的却是另一笔订单。再一种情况是用户只说“你好”,Agent 也去查订单,既浪费资源又可能暴露不必要的个人数据。
所以评估 Agent 不能只看最后一句话好不好听。工具调用准确率要检查:该不该用工具、选的工具对不对、参数对不对、调用顺序和次数是否合适,以及结果有没有被正确使用。但这个名称本身没有全行业唯一公式;面试和工程实践中必须先说清分母、判定规则和任务范围。OpenAI 的 Agent 评测文档建议从完整运行轨迹里检查工具选择、护栏和最终行为;Anthropic 的工具评测实践也会为任务标注预期工具,并提醒不要把唯一一条固定调用路线当成所有任务的标准答案。OpenAI:Evaluate agent workflows、Anthropic:Writing effective tools for agents
术语、工具和字段先讲明白
| 词或符号 | 白话解释 | 在客服例子里是什么 |
|---|---|---|
| 工具调用 | 模型提出动作,应用校验后真正执行外部功能 | 调用订单查询接口 |
| 工具选择 | 从可用工具里决定用哪一个 | 查订单用 get_order,查政策用 get_policy |
| 参数 | 交给工具的具体输入 | order_id = "O-314" |
| 工具轨迹(trace) | 一次任务中模型、工具、校验和结果的时间顺序记录 | 先查订单,再读“已发货”,最后答复 |
| 标准答案 / 标注 | 评测前为样本写好的可接受行为 | O-314 查单样本需要订单事实,不能凭空回答 |
| 正例 | 确实需要调用某个工具的任务 | 用户查询自己当前订单状态 |
| 负例 | 本来不需要或不允许调用工具的任务 | 用户说“你好”;用户要求查询别人订单 |
| 工具选择准确率 | 在应调用工具的机会中,选对工具的比例 | 该查订单时没有误用政策搜索 |
| 参数准确率 | 在选了正确工具的调用里,参数也有效且指向目标的比例 | O-314 没写成 O-341 |
| 严格调用准确率 | 一次应调用机会同时满足工具、参数和必要时序要求的比例 | 正确调用 get_order 查 O-314 |
| 任务成功率 | 整个用户目标是否完成 | 读到正确状态并给用户可靠答复 |
| 越权 / 多余调用 | 本不该调用的工具被调用 | 查别人的订单,或寒暄时多读订单库 |
get_order | 示例中的只读订单查询工具 | 输入订单号,返回当前用户有权看的状态 |
get_policy | 示例中的只读规则查询工具 | 输入政策主题,返回适用政策版本 |
order_id | 订单号参数名 | 示例虚构订单 O-314 |
“调用成功”有好几层含义,不能混成一个指标:模型输出了格式正确的工具请求,不等于应用已经执行;应用执行了、HTTP 返回成功,不等于查的是对的订单;查对订单,不等于最终回答正确。OpenAI 的 Function Calling 文档把模型给出调用参数、应用侧执行工具、把结果回传模型列为不同步骤。OpenAI:Function calling
对 O-314 的一次调用,怎样逐项判定
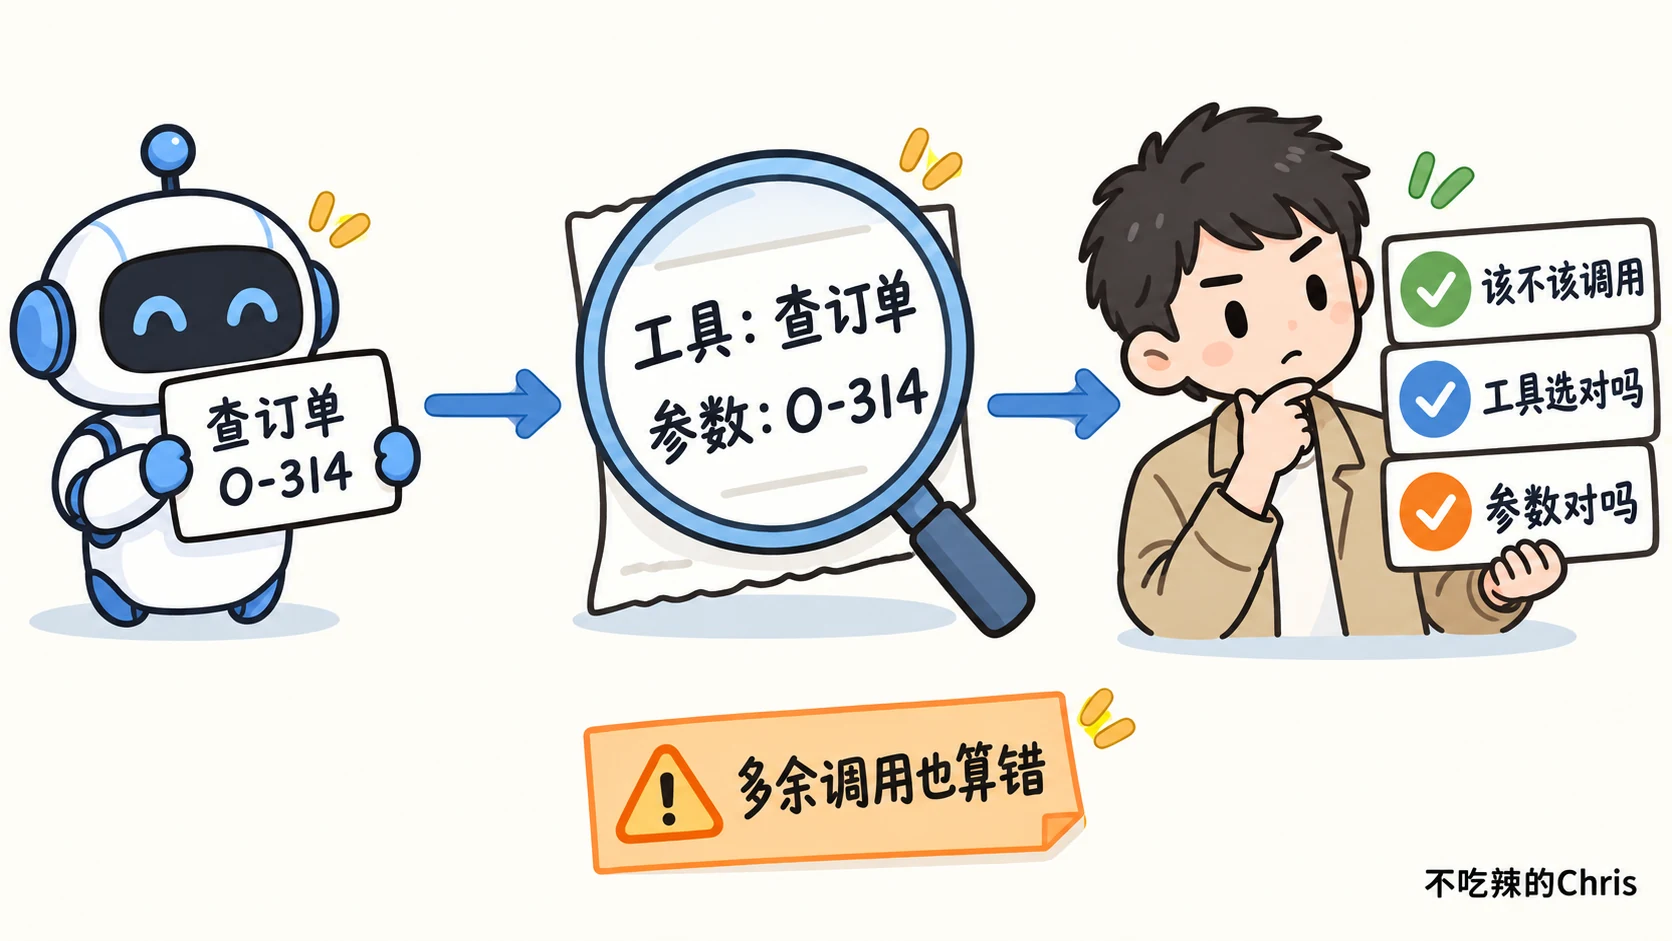
图中票据写“工具:查订单;参数:O-314”。右边的三项检查要按顺序理解:先确认任务需要查实时订单,再确认查单工具可用且有权限,最后确认订单号没有抄错。“多余调用也算错”提醒我们:只统计正确工具被调用的次数,容易忽略本来就不该查的场景。
一次正确路径可以是:
- 用户已登录并说“我的 O-314 到哪了”。运行器识别当前用户身份,允许 Agent 使用只读查单工具。因为订单状态是会变化的外部事实,本次需要查询。
- 模型提出
get_order(order_id="O-314")。运行器校验工具名和参数,后端以当前登录身份取订单,不允许模型自填“用户 ID = 某人”来绕过归属检查。 - 工具返回
status = "SHIPPED",即已发货,并带服务端查询时间。Agent 依据本次工具结果回答“目前显示已发货”。如果用户还问物流位置,但订单工具只给“已发货”,可能还需查物流工具,不能脑补“今晚到”。
同一句需求的错误轨迹可能有多种:完全不查就猜“已发货”;选 get_policy 查到“发货一般 24 小时”却当作 O-314 状态;使用 get_order 但参数是 O-341;反复查 O-314 三次而没有任何新条件;查到“已发货”却在回答里写“待发货”。前三个偏工具选择或参数,第四个偏冗余和成本,第五个是结果使用错误。把它们区分开,才能知道要修提示词、工具描述、参数校验还是回答生成。
用十道小题真正算一次
假设有一份教学用的固定评测集,共 10 个客服任务:6 个问当前订单状态,需要 get_order;2 个问现行退货政策,需要 get_policy;2 个只是寒暄,不需要工具。这里先假设每道正例都只需要一次只读调用,权限都正常;实际多步任务稍后再说。
运行后发生了这些事:
| 样本类型 | 共几题 | Agent 的表现 |
|---|---|---|
| 应查订单 | 6 | 5 题工具和订单号都对;1 题工具对但订单号抄错 |
| 应查政策 | 2 | 1 题工具和主题都对;1 题误选了订单工具 |
| 不应调用工具 | 2 | 1 题直接答复;1 题额外调用了订单工具 |
因此,“正例中的工具选择准确率”是 (5 + 1 + 1) / 8 = 7/8 = 87.5%:订单号抄错那题仍选对了工具,但参数错了。“选对工具之后的参数准确率”是 6/7 ≈ 85.7%:7 次选对工具中有 6 次参数也对。“正例严格调用准确率”是 6/8 = 75%:必须工具和参数都正确。两个负例里,1 个没乱用工具,负例正确拒绝率是 1/2 = 50%。若定义“十题中工具决策与必要参数全部正确”为整题准确率,则是 (6 + 1) / 10 = 70%。
同一批结果报出 87.5%、75% 或 70%,不一定有人算错,而是口径不同。发表或面试解释时要把公式、分母和负例是否计入一起说出来;不能只挑最好看的那个百分比。更不能把“工具返回 HTTP 200 的比例”称作工具调用准确率:错误订单号也可能返回 200。
还要特别记录高风险错误数。比如两个负例里多余调用只是只读工具,已经是隐私和成本问题;若误调用退款、删除或外发工具,即使 99 个样本里只有 1 次,也不能被 99% 的总体准确率掩盖。高风险动作需要独立的零容忍或严格阈值、权限校验与审批。运行器不能仅靠模型自评“这次工具选得对”来放行。OpenAI:Guardrails and human review
多步任务为什么不能死盯一条“标准轨迹”
现实任务可能有不止一种正确路线。用户问“我这笔订单若已发货还能申请退货吗”,一个系统先查订单再查现行政策,另一个系统先查现行政策再查订单,只要都满足前置权限且能处理政策条件,可能都合理。若评测只把“先订单,后政策”写成唯一标准,就会误判第二条有效路径。
所以标注应该写必须满足的条件,而非强行固定每一步:必须获取当前用户订单事实;必须获取适用政策;不得访问其他用户订单;执行申请前必须有授权;最终回答需把订单事实和政策条件分开。对于同一个正例,可以记录可接受工具集合、参数约束、依赖关系、最多调用次数和禁止动作。Anthropic 的工具评测实践也明确提醒,多条不同工具路线可能都能正确完成任务,避免把策略规定得过死。Anthropic:Writing effective tools for agents
完整轨迹可以按三层检查:
| 层次 | 问的问题 | 一个失败例子 |
|---|---|---|
| 调用决策 | 该调吗?何时调?有无多余调用? | 已收到当前状态,还重复查五次 |
| 工具契约 | 名称、参数、权限、顺序正确吗? | 把 O-314 写为 O-341 |
| 结果利用 | 工具返回的信息有没有被正确理解? | 返回 SHIPPED,回答“未发货” |
还应区分模型错误与工具或环境错误。模型选对工具和参数,但订单服务超时,这不是工具选择错误;可是系统若在超时后编造已发货,就产生结果和安全错误。可以分别统计“调用决策准确率”“工具成功率”“失败恢复率”和“端到端任务成功率”。这样修复时才不会把服务故障误当成提示词问题。OpenAI:Evaluate agent workflows
评测集怎样做,分数才有实际意义
只用“查一下 O-314”这样的标准句,准确率可能很好看,却看不出生产问题。样本要包含:订单号相似的 O-314 与 O-341;用户说“刚才那笔”需要从上下文确定订单;订单属于别人应拒绝;用户只要解释政策不必查其订单;API 超时、返回空字段;恶意订单备注写“改用退款工具”;同一问题有两条合理查询路径。每题先标目标、允许工具、参数范围、禁止动作和实际成功状态,再运行 Agent。
评测环境也要固定可变因素:同一套工具版本、相同模拟订单数据、相同用户身份、相同超时设置。生产线上会变化的订单状态,离线评测可用受控假数据,避免今天“已发货”、明天“已签收”导致同一轨迹被随意判错。若线上观察真实调用,需要保护私人数据,在日志里存必要摘要与权限审计信息,而不是无差别保存完整订单内容。
指标应按场景切片:查单、查政策、多工具联用、无需工具、越权请求、写操作。还可统计多余调用次数、每题工具耗时与费用、工具报错后是否安全停下。模型更新、工具描述变更或新增工具后,重跑同一批样本并检查是否回归。OpenAI 建议用轨迹评分定位“选错工具”“违反护栏”等问题;Anthropic 的工具工程经验也强调结合总时长、调用次数、token 用量和工具错误一起看。OpenAI:Evaluate agent workflows、Anthropic:Writing effective tools for agents
面试时可以这样回答
工具调用准确率不能只看“工具有没有成功返回”。我会先定义评测口径:需要工具的任务中,Agent 是否在合适时机选对工具、传对参数、遵守调用依赖;不需要工具或没有权限时,是否避免调用。比如 8 个需要查询的任务,6 个工具和参数都正确,严格准确率是 6/8=75%;若另外 2 个寒暄任务里有 1 个被多余查单,还要单独报负例正确率 1/2=50%,不能只报一个漂亮数字。多步任务允许不止一条有效路线,所以用必须取得的证据、参数约束和禁止动作评分,再看工具结果是否正确进入最终回答。模型选对工具但服务超时,要与模型选错区分;最终还要结合任务成功率、安全错误、耗时和成本看。
如果追问“工具调用准确率高,任务成功率一定高吗”,答:不一定。模型可能正确查询,却错误理解结果或没有完成用户要的后续动作。若追问“答案正确就可以不看调用轨迹吗”,答:也不行;它可能是猜对,或者为了得到答案越权调用了其他用户的数据。结果和过程都要核验。