Appearance
Q7 · LangChain 核心组件详解
用户问:“订单 A123 能退款吗?”如果只把这句话发给大模型,模型不知道 A123 是谁的订单、什么时候签收,也不知道这家店当前的退款政策。它可能用一般常识回答,但这不是可靠的业务处理。
一个应用要回答好这个问题,至少要完成三类动作:告诉模型这次要做什么、从哪里取事实、按什么顺序完成任务。LangChain 提供了一套把这些动作接起来的组件。先把每个组件在这笔订单中的职责说清楚,再看代码,才不会变成背英文名。
本文的订单、政策和输出均是假设数据,用于解释程序结构;真实退款资格应以业务系统中的当前规则为准。
文中会遇到的词和代码名字
| 词 | 通俗解释 | A123 退款咨询中的角色 |
|---|---|---|
| 大模型 / Chat Model | 接收消息、生成文本或提出工具调用请求的模型 | 阅读证据后组织答复 |
| Message(消息) | 带有来源角色的一段输入或输出 | 应用规则、用户问题、工具返回值分别放在不同消息中 |
| Prompt(提示词) | 本次模型调用的任务说明及相关输入 | “只按已核实的订单与政策作答” |
| Prompt Template(模板) | 带变量位置、可反复填入不同数据的提示词 | 把 {question} 换成每位用户的实际问题 |
| Retriever(检索器) | 从资料集合中找出相关文档的组件 | 找到适用的退款政策条款 |
| Tool(工具) | 让程序查询或操作外部系统的能力 | 查询订单状态;获批后才可能调用退款接口 |
| Runnable | 具有统一调用方式的可执行步骤 | 一步读取输入、产生输出,能与别的步骤连接 |
| LCEL | 用 ` | ` 等方式组合 Runnable 的表达方式 |
| Agent | 由模型在运行中选择下一步的程序循环 | 根据问题决定先查政策还是查订单 |
| 结构化输出 | 让结果按约定字段交给程序处理 | 返回“结论、依据、待补信息” |
| State(状态) | 一次任务当前积累的数据 | 已查到的订单、政策、工具结果 |
| Checkpoint(检查点) | 任务进度的保存点 | 长任务中断后,从保存的进度接着处理 |
| Trace(追踪记录) | 一次请求经过了哪些步骤及耗时、错误 | 排查是检索错、工具失败,还是模型理解错 |
看到 {question} 这种花括号时,把它当成表格里的“待填空格”,不是一个神秘命令。看到 | 时,把它当成“前一步输出送给后一步”;它并不表示两个步骤自动同时执行。
A123 这句话怎样变成有依据的答复
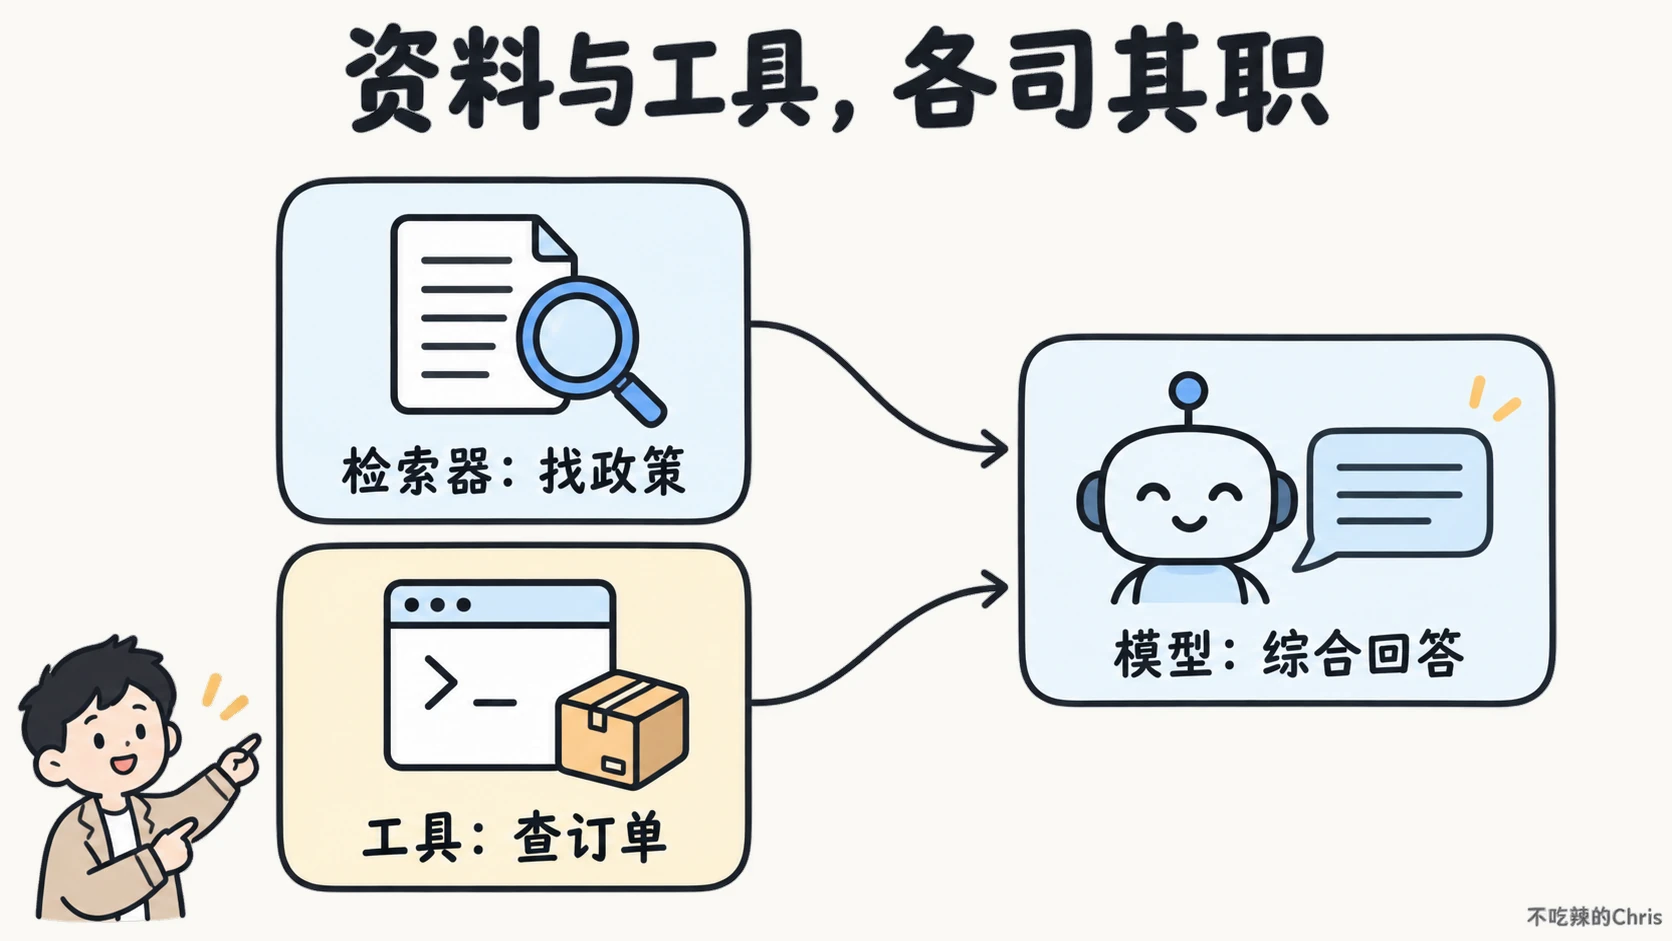
假设用户已经登录。一次比较可靠的处理可以这样走:
- 接收问题和身份:应用得到“订单 A123 能退款吗”,先知道当前登录用户是谁。身份校验由程序完成,不交给模型猜。
- 查询订单:通过订单工具,确认 A123 属于该用户,获取商品类别、签收时间、是否已有退款申请等事实。
- 查政策:按商品类别与时间,从政策文档中找到适用版本。这里的检索结果是候选证据,还要核对版本与适用范围。
- 组织模型输入:把用户问题、核实过的订单事实和相关政策放进消息,明确“资料不足时先说缺什么,不要编造”。
- 生成并检查结果:模型形成结论和依据;程序检查字段格式、权限、金额或日期等确定性规则,再展示给用户。
图中的两路输入是“可能需要的证据”,不是说每个问题都必须调用两种能力。用户若只是问“退货政策在哪里”,可能只需检索政策;用户问“A123 的退款进度”,则要先查订单。决定要不要调用某一步,正是编排层要处理的事。
这张流程图省略了权限检查、失败重试和审批等工程环节;它只帮我们分辨各组件的输入与产出。不能因为画了一个箭头,就以为业务系统已提供相应数据。
消息、模板和模型分别负责什么
消息:把规则、问题和工具结果分开
模型读到的是消息集合。应用级要求可以写成 System 或 Developer 消息,用户本次问题是 User 消息,工具执行的结果通常以 Tool 消息送回。模型返回的 Assistant 消息可能是一段回答,也可能包含“我想调用某个工具”的请求。
提出工具调用请求与完成工具执行是两回事。 例如模型提出“查询 A123”,真正访问订单数据库的是应用运行时;运行时还必须检查“当前用户是否能看 A123”。如果模型可以一句话直接读别人的订单,问题在权限设计,不在提示词是否写得礼貌。
模板用来避免每次都手工拼接相似的任务说明。下面这个简化输入有三个待填位置:
text
规则:只依据已提供的政策和订单事实回答;资料不足时说明缺什么。
政策:{policy}
订单:{order_status}
用户问题:{question}
{policy} 是本次检索出的政策,{order_status} 是订单工具返回的已核实状态,{question} 是用户原话。若缺少政策,就不能随便拿模型记忆里的“常见七天规则”填空;应改为说明无法判断,或再查政策。
模型负责理解这些内容并组织回答,不负责保证输入资料本身正确。把过期政策传进去,再写“务必准确”,仍可能得到依据错误但语气肯定的答案。
检索器:在文档中找候选资料
政策可能有几百页,也可能按商品类别和生效日期分成很多版本。Retriever 接收查询条件,返回相关文档片段。它可以基于关键词、向量相似度或混合方式实现;对初学者来说,先理解成“在文档库中找可能相关的几段资料”就够了。
检索并不等于判断。找到了“耳机退款规则”的一段文字,还要看它是否适用于 A123 的商品、是否已经失效、是否有更高优先级的特殊条款。若检索不到、找到两个互相冲突的版本,应用应明确失败路径:继续查询、要求人工确认,或者告知暂无法判定。不能让模型把“没有证据”说成“政策允许”。
工具:访问文档之外的系统
Tool 通常是开发者注册给 Agent 使用的函数或服务接口。例如 get_order_status(order_id) 中,order_id 是传入的订单号;函数的输出可能是“签收于 9 月 1 日,商品为耳机”。这个名字只是开发者起的,关键是它拿什么输入、做什么动作、返回什么结果。
“查订单”是读取外部系统;“提交退款”是改变外部系统,两者风险不同。真实退款工具需要用户归属校验、金额校验、审批、超时处理和防重复请求。模型即使提出调用,也不能越过这些程序规则。查询接口失败时,答复应区分“查不到订单”与“查询服务暂时不可用”;这会影响用户下一步该怎么做。
Runnable 和 LCEL 如何把固定步骤连起来
Runnable 的关键在于统一的调用方式:给一个输入,得到一个输出,通常通过 invoke 调用。许多 Runnable 还支持批量、异步或流式处理。LCEL 的 | 表达“前一步输出交给后一步”,形成一个固定顺序的 RunnableSequence。
先看一个不调用模型、不访问业务系统的小例子,只为了看清数据怎样走。变量在代码前先说明:
clean_question:去掉用户输入前后的空格,输出仍是一句话。make_task:给这句话加一个任务前缀,输出给下一步处理的文字。flow:把这两步连起来的固定流程。raw_question:演示输入,前后故意带空格。RunnableLambda:把普通 Python 函数包装成能参加 LangChain 流程的 Runnable;这里的 Lambda 是组件名称,并不是说代码中的两个函数必须写成 Python 的lambda表达式。invoke:让一个 Runnable 对某个输入实际运行一次。
bash
pip install -U langchain-corepython
from langchain_core.runnables import RunnableLambda


def clean_question(text: str) -> str:
    return text.strip()


def make_task(question: str) -> str:
    return f"请核实订单事实后回答:{question}"


flow = RunnableLambda(clean_question) | RunnableLambda(make_task)
raw_question = "  订单 A123 能退款吗?  "
print(flow.invoke(raw_question))
运行结果是 请核实订单事实后回答:订单 A123 能退款吗?。过程很具体:第一步去掉空格,第二步给清理后的文字加前缀。这仍然只是文本加工,不会真的查询订单;需要查询能力,还要接上有权限的工具或检索步骤。
若你不熟悉 Python:text.strip() 是去掉字符串首尾空格;text: str 里的 str 说明输入预期是一段文字;f"...{question}" 会把变量 question 的内容填到花括号处。代码里的 | 把两个已包装的步骤按顺序连接,最后的 flow.invoke(raw_question) 才触发运行。
真实 LCEL 流程可以把“格式化 Prompt → 模型 → 结果解析”按固定顺序连接。固定顺序的好处是每次执行路径容易预测、容易测试。若任务需要“看完本次问题再决定用哪个工具、工具失败后是否换一个工具”,就要在固定管道之外写选择逻辑,或使用 Agent。LCEL 并非技术上完全不能分支;只是复杂有状态的分支与暂停恢复,通常在 LangGraph 中表达更清楚。
Agent 为什么还要多一次“选择下一步”
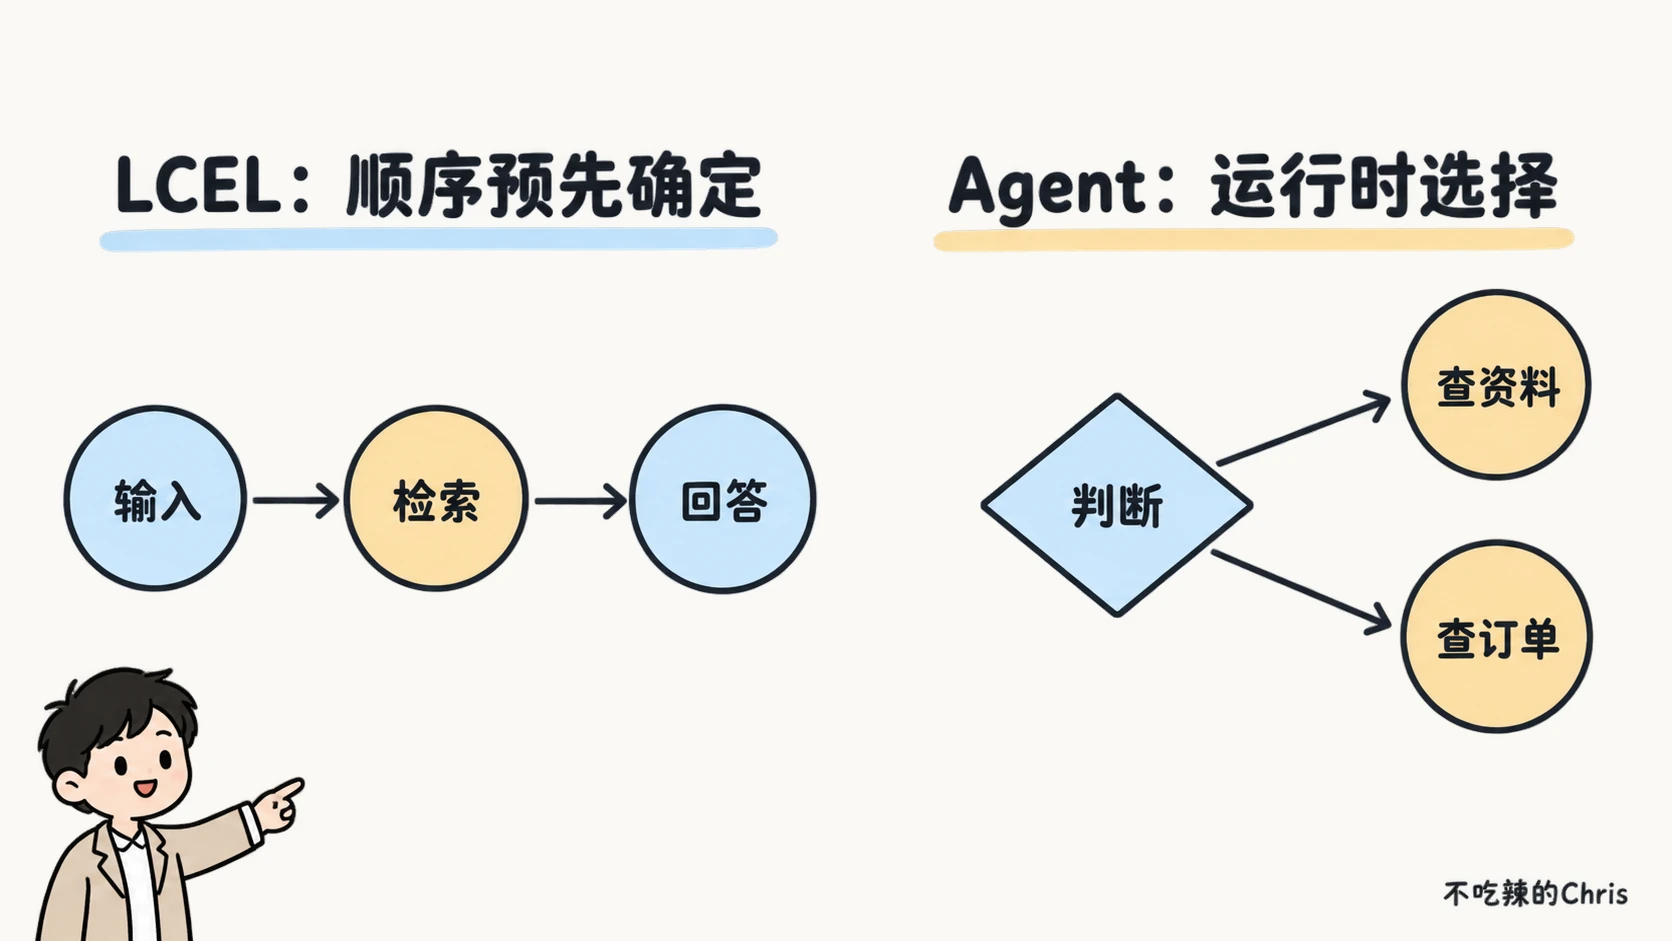
左边是一条预定路线;右边是运行中根据现有信息选择动作。LangChain 当前的 create_agent 提供预制的模型与工具循环,并构建在 LangGraph 之上。一个工具型 Agent 大致这样工作:
- 给模型当前用户问题、已知事实和可用工具说明。
- 模型判断:可以直接答,还是需要一个工具结果?若需要,它返回工具名称与参数。
- 程序检查参数、权限和调用次数,再真正执行工具。
- 工具结果返回给模型;模型可以据此继续调用工具或形成最终答复。
- 达到完成条件、调用上限、超时或错误处理条件时结束。
例如用户问“A123 现在到哪一步了”,Agent 可能选择 get_order_status;若用户问“这类耳机的退货条件”,它可能优先查政策。Agent 的价值是运行时选择,不是让模型拥有无限权限。 生产中要限制它能看到的工具、每次调用的时间和次数,并记录每一步。
如果所有咨询都必须“先查政策、再查订单、最后回答”,固定工作流更简单。若需要自定义审批、循环、断点恢复,显式使用 LangGraph 更合适。选型可按问题复杂度从低到高:
| 任务 | 起步方案 | 原因 |
|---|---|---|
| 只把一段文字改写得更清楚 | 直接调用模型 | 不需要工具或复杂编排 |
| 每次都走同样两三步 | Runnable / LCEL 或普通程序流程 | 顺序可预期 |
| 模型要按问题选择工具 | LangChain create_agent | 预制工具调用循环 |
| 有复杂分支、人工审批、长时间暂停恢复 | 显式 LangGraph | 状态与控制路径需要写明 |
不要说“LangChain 只能做线性 Chain”。这是把旧教程里的 Chain/LCEL 与当前 LangChain Agent 混在一起了。Q8 会把 State、Node、Edge 和 Checkpointer 逐一拆开。
结果要给程序用时,还需要什么
人能看懂“可能符合退款条件”,程序却未必知道它该显示按钮、追问资料,还是转人工。因此常用结构化输出约定字段,例如 decision(处理方向)、reason(原因)、missing_fields(缺哪些数据)。模型生成后,程序还要检查字段类型和业务条件。
例如:
json
{
  "decision": "need_more_information",
  "reason": "缺少签收时间",
  "missing_fields": ["delivered_at"]
}
need_more_information 表示先补信息,delivered_at 表示签收时间。即使字段格式完全正确,若订单事实是假的,结论仍然会错。结构化输出负责让结果容易被程序读取,业务校验负责判断能不能信、能不能执行。
对话状态也要单独考虑:一次模型调用不会自动拥有永久记忆。程序需要决定保存哪些历史消息、哪些工具结果要裁剪、长任务是否用检查点保存。追踪记录则帮助排查:答案错了,是检索给了旧政策、工具查到了别人的订单、模型比对错了,还是输出校验漏了?不同问题要改不同层。
面试时怎样回答这道题
我会用一笔订单咨询说明 LangChain 的组件:消息和 Prompt 先明确任务与回答边界;检索器找政策文档,工具查实时订单事实;模型依据这些输入组织答复。Runnable/LCEL 适合把已知步骤按固定顺序连接,Agent 适合在运行时判断要不要调用工具、下一步调用哪个工具。若任务需要复杂分支、审批或暂停恢复,再显式用 LangGraph 管理状态。结构化输出便于程序读取,但权限、事实核对、防重复操作仍由业务系统负责。
面试官若追问“Retriever 与 Tool 有什么不同”,就回到 A123:前者通常在文档集合里找候选证据,后者访问外部系统或动作接口;实现上检索能力也可以包装成工具,二者是职责角度的区分,不必把边界说成绝对的类名限制。若追问“Tool Call 是否等于工具已经执行”,回答应明确:模型只是提出调用请求,运行时校验后才执行,并把结果送回来。