Appearance
Q4 · Agent 在工具调用过程中如何处理错误和重试?
难度 P0 必背 · 岗位 算法 / 应用 · 预计阅读 9 min 关键词 error-handling · retry · robustness · agent-loop · fallback
假设 Agent 要查询订单,第一次请求因网络超时失败。此时重试可能成功;如果失败原因是“订单号格式不对”,原样重试只会重复出错。错误处理的第一步是分清失败类型,再决定重试、修改参数、换工具或停止。
先认清几个词
| 词 | 含义 | 在订单查询里 |
|---|---|---|
| 瞬态错误 | 可能很快恢复的临时故障 | 网络超时、服务暂时不可用 |
| 确定性错误 | 输入或权限不变时重复调用仍会失败 | 参数无效、认证失败 |
| 重试 | 在有限次数内再次执行同一动作 | 超时后重新查询订单 |
| 指数退避 | 每次重试前逐步延长等待时间 | 等 1 秒、2 秒、4 秒 |
| 兜底限制 | 防止系统无限尝试的程序约束 | 最多调用次数和总耗时 |
能否重试由程序根据错误类型判断;能否换方法可交给模型规划;总次数和耗时必须由程序限制。
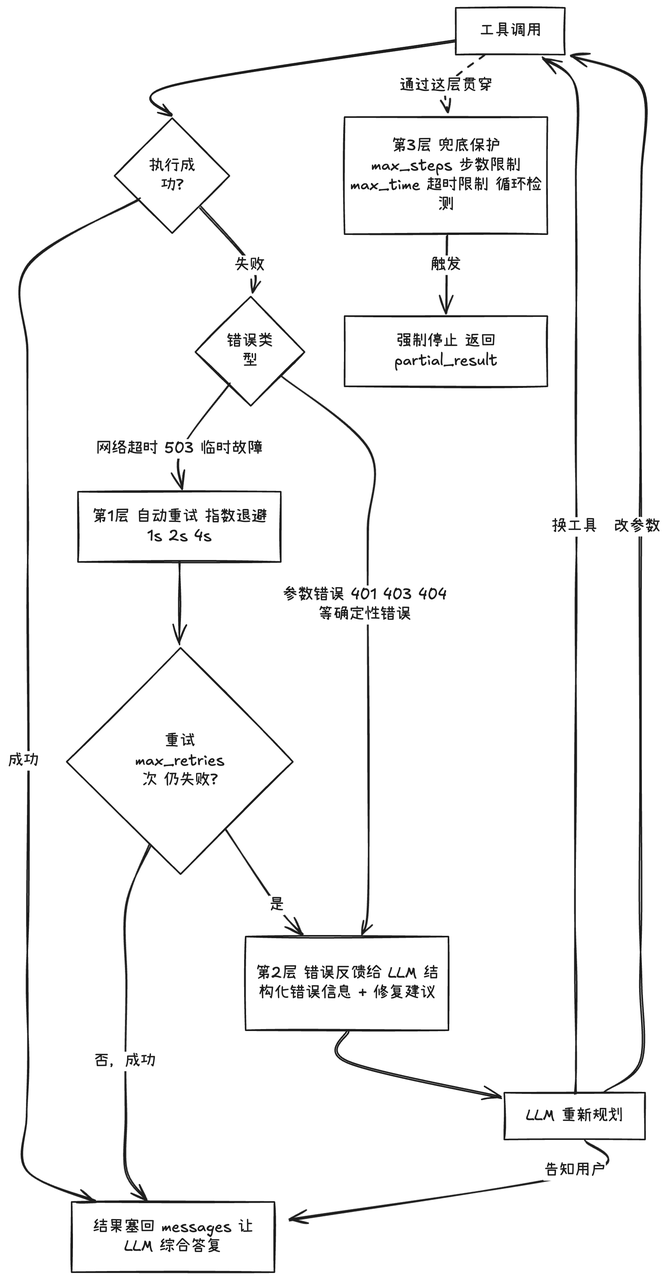
错误发生后走哪条路
逐步拆开看
工具调用错误处理我分三层:
第一层是自动重试 ,网络超时这种瞬态错误用指数退避重试几次;
第二层是错误反馈给 LLM ,把失败信息清晰地返回给模型,让它重新规划(换工具、改参数、或者直接告诉用户);
第三层是兜底保护 ,设置最大步数和超时限制,防止无限循环。
第一层:自动重试,处理瞬态错误
不是所有错误都值得重试 。网络超时、服务暂时不可用(503)这类瞬态错误可以重试;但参数错误、认证失败(401)、权限不足(403)这类错误重试多少次都没用。
重试策略通常用指数退避 :第一次等 1 秒,第二次等 2 秒,第三次等 4 秒……这样既能给服务恢复的时间,又不会疯狂轰炸。
python
def execute_with_retry(tool, args, max_retries=3):
    for attempt in range(max_retries):
        try:
            return {"success": True, "result": tool.run(**args)}
        except TimeoutError:
            if attempt < max_retries - 1:
                time.sleep(2 ** attempt)  # 指数退避:1s, 2s, 4s
            else:
                return {"success": False, "error": "工具调用超时", "retryable": True}
        except ParameterError as e:
            # 参数错误不重试,直接返回让 LLM 处理
            return {"success": False, "error": f"参数错误:{e}", "retryable": False}
        except AuthError as e:
            return {"success": False, "error": f"认证失败:{e}", "retryable": False}
关键设计是 retryable 标志,告诉上层这个错误值不值得重试 。不要无脑写一个循环重试所有错误,那是浪费时间还会触发限流。
第二层:错误反馈给 LLM,让它重新规划
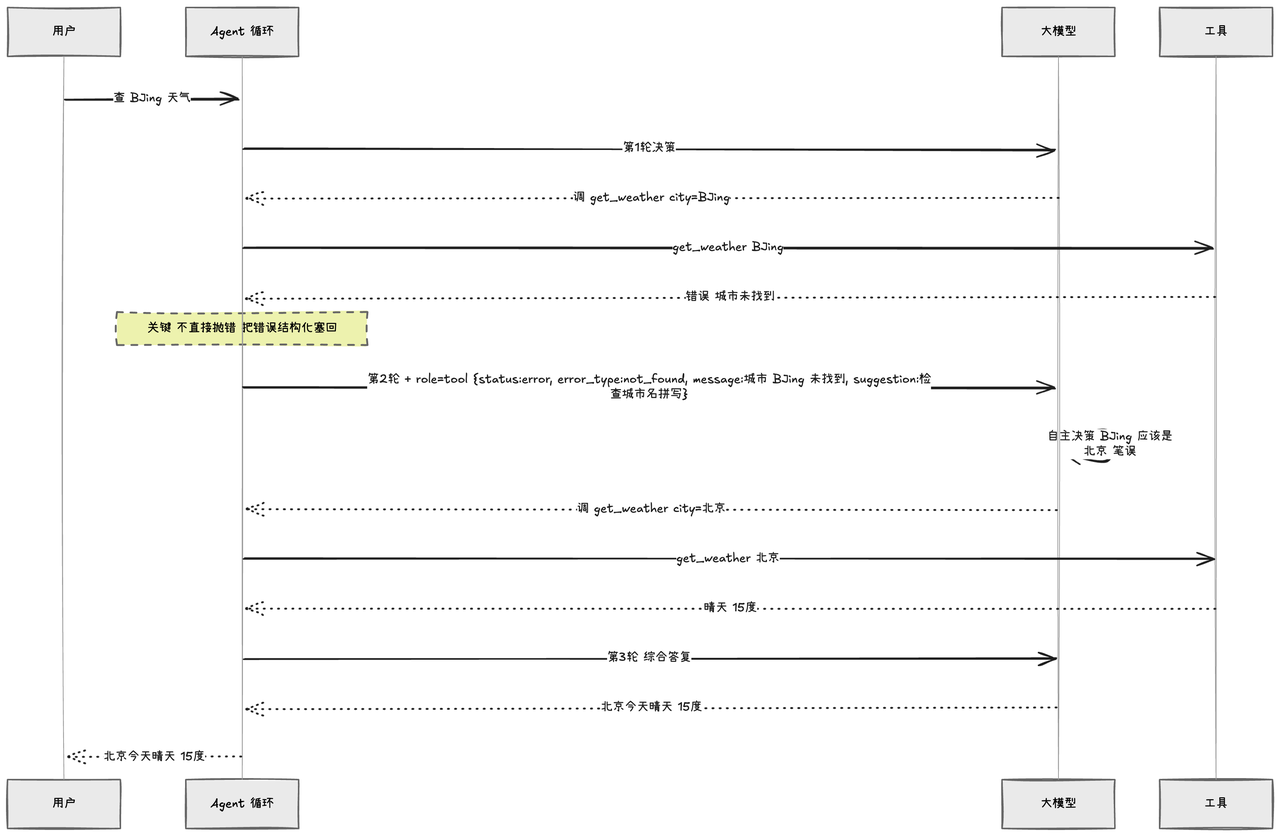
这是 Agent 和简单自动化脚本的本质区别 。不是工具一失败就崩掉,而是把错误信息给 LLM,让它决定下一步怎么办。
python
def agent_step(messages, tools):
    # ↓ 步骤 1:LLM 决策
    response = llm.chat(messages, tools=tools)

    if response.finish_reason == "tool_calls":
        tool_call = response.message.tool_calls[0]
        tool_name = tool_call.function.name
        args = json.loads(tool_call.function.arguments)

        # ↓ 步骤 2:执行工具
        result = execute_tool(tool_name, args)

        if not result["success"]:
            # ↓ 步骤 3:关键 - 把错误信息清晰地告诉 LLM
            error_observation = {
                "role": "tool",
                "tool_call_id": tool_call.id,
                "content": json.dumps({
                    "status": "error",
                    "error_type": result["error_type"],     # 错误类型
                    "message": result["error"],              # 错误信息
                    "suggestion": result.get("suggestion", "")  # 修复建议
                })
            }
            messages.append(error_observation)

            # ↓ 步骤 4:LLM 重新规划,可能:
            # 1. 换别的工具
            # 2. 调整参数再试
            # 3. 告诉用户无法完成
            return agent_step(messages, tools)  # 递归,让 LLM 重新决策
        else:
            # 成功,正常继续
            messages.append({"role": "tool", "tool_call_id": tool_call.id, "content": result["result"]})
            return agent_step(messages, tools)
错误信息怎么写很重要 。看这两个版本:
text
❌ 差:"Error: API failed"
✅ 好:"Error: 天气 API 返回 404,城市 'BJing' 未找到。
        可能原因:1.城市名拼写错误 2.该城市不在支持列表。
        建议:检查城市名称是否为标准中文名。"
详细、可操作的错误信息能让 LLM 做出更好的决策 。这是错误处理设计的核心:把错误从「故障」变成「上下文」。
第三层:兜底保护,防死循环
Agent 的循环本质上是 while True,必须有停止条件 :
python
class SafeAgent:
    def __init__(self, max_steps=15, max_time=60):
        self.max_steps = max_steps      # 最大步数限制
        self.max_time = max_time        # 超时限制(秒)
        self.step_count = 0
        self.start_time = time.time()
        self.action_history = []        # 记录历史行动,用于检测循环

    def run(self, task):
        messages = [{"role": "user", "content": task}]

        while True:
            # ↓ 检查 1:步数限制
            if self.step_count >= self.max_steps:
                return {"status": "stopped", "reason": "达到最大步数", "partial_result": messages}

            # ↓ 检查 2:超时
            if time.time() - self.start_time > self.max_time:
                return {"status": "stopped", "reason": "超时", "partial_result": messages}

            # ↓ 检查 3:是否陷入循环(同样的行动重复执行)
            current_action = self.get_next_action(messages)
            if self.is_looping(current_action):
                return {"status": "stopped", "reason": "检测到循环", "partial_result": messages}

            self.action_history.append(current_action)
            self.step_count += 1

            # 执行行动...
循环检测 可以用简单的哈希:把(工具名 + 参数)哈希值存起来,如果短时间内重复出现,说明 Agent 在原地打转,需要强制停止。
更细致的实现可以做「滑动窗口循环检测」:最近 N 步内同样的 (action, params) 出现 ≥ 2 次就判定为循环。
降级策略
对于关键工具,可以设计备用方案 :
python
def search_with_fallback(query):
    # ↓ 主工具:Google 搜索
    result = google_search(query)
    if result["success"]:
        return result

    # ↓ 一级降级:Bing 搜索
    logger.warning(f"Google 搜索失败,降级到 Bing: {result['error']}")
    result = bing_search(query)
    if result["success"]:
        return result

    # ↓ 最终降级:本地知识库
    logger.warning(f"Bing 搜索失败,降级到本地检索")
    return local_kb_search(query)
降级策略和 LLM 决策可以互补 :低层用降级保证「至少有结果返回」,高层让 LLM 知道「这是降级结果,可信度可能较低」,由 LLM 决定要不要采用。
重试策略容易出错的地方
踩坑 1:所有错误都无脑重试
错误描述 :写一个 while retry < 5: try: ... except: continue 通杀所有异常。
正确做法 :明确分类错误。瞬态错误 (超时、5xx)才重试;确定性错误 (参数错、认证错、404)立即停止重试,反馈给 LLM 让它换策略。无脑重试会浪费时间、触发限流,甚至放大问题。
踩坑 2:错误信息只写一句 "API failed"
错误描述 :把 raw exception 当成错误信息塞回 LLM,或者写「调用失败」三个字。
正确做法 :错误信息要 结构化 + 可操作 :错误类型、具体原因、可能的修复建议。让 LLM 能凭这些信息做决策(换工具/改参数/放弃),而不是让它「猜」。
踩坑 3:忘了设最大步数和超时
错误描述 :Agent 跑起来后突然「卡住」,原因是 LLM 在两个工具之间反复横跳,没有上限。
正确做法 :任何 Agent 循环必须有 max_steps 和 max_time 兜底。生产环境推荐 max_steps = 15~20,max_time = 60~120 秒。再加一层「循环检测」防止在小步数内反复同一动作。
踩坑 4:重试策略用固定间隔(每次都等 1 秒)
错误描述 :time.sleep(1) 重试 N 次。
正确做法 :用指数退避 (1s → 2s → 4s → 8s),更友好,给服务恢复时间,也减少限流压力。生产中可以加一点 jitter(随机扰动)避免「重试惊群」。
踩坑 5:把降级当成 LLM 决策的替代品
错误描述 :搜索 Google 失败就自动 fallback 到本地知识库,不告诉 LLM 这是降级结果。
正确做法 :降级的结果应该带降级标记 塞回 LLM,让 LLM 知道「这是次优结果」并据此调整后续决策。否则 LLM 可能基于不准确的本地知识库结果给出错误答案。
再往下追问时怎么解释
- 追问 1:循环检测具体怎么实现? 答题要点:① 简单方案 — 把
(tool_name, sorted_args)哈希存集合,重复出现立即停。② 进阶方案 — 滑动窗口(最近 N=5 步内同样 action 出现 ≥ 2 次判定循环)。③ 高级方案 — 给 LLM 看历史 action 列表,让它自己判断「我是不是在转圈」。
① 简单方案:哈希去重集合 (Strict Deduplication)
这是最基础的“硬拦截”方案,适用于完全重复的无效调用。
- 实现步骤:
特征提取:将当前 Tool 调用中的
tool_name和arguments提取出来。标准化处理:为了防止字典顺序导致的哈希差异,对
arguments进行键排序(Sorted Keys)。哈希存入:生成一个唯一标识
hash(tool_name + sorted_json_args),并将其存入该轮对话的set集合中。即时拦截:在每次执行 Tool 前,检查哈希值是否已存在。如果存在,直接截断并返回错误提示给 LLM(例如:“你已经尝试过此操作且结果一致,请尝试其他策略”)。
② 进阶方案:滑动窗口启发式判定 (Sliding Window Pattern)
简单方案无法处理“参数微调但本质重复”的情况。滑动窗口能识别出在短时间内频繁出现的相似行为。
实现步骤:
维护队列:维护一个固定长度(例如 N=5)的动作队列(List)。
模式匹配:不仅记录
(tool, args),还可以记录(tool, action_type)。频率判定:在窗口内统计同一个动作出现的次数。如果同一动作出现 大于2次,或同一工具连续出现 3 次且 Observation 变化极小,则触发循环报警。
分级响应:
第一次重复:在 Prompt 中插入强力提醒(Warning)。
第二次重复:强制终止调用。
为什么是 N=5?
- 因为一个正常的复杂任务通常需要 3-5 步组合动作。如果 5 步内出现了 2 次一模一样的调用,大概率是模型逻辑撞墙了。
③ 高级方案:LLM 语义自省 (LLM Self-Reflection)
利用 LLM 的语义理解能力,识别出“参数变了但逻辑没变”的循环(语义循环)。
- 实现步骤:
构建轨迹上下文:将最近 K 轮的
Thought -> Action -> Observation链路完整保留。引入判定提示词:在 System Prompt 中加入一段逻辑:"检查你之前的行为轨迹。如果你发现自己连续多次尝试类似操作但没有进展(例如:反复搜索同一个关键词的变体,或反复读取同一个文件),请立即停止调用工具,并向用户解释你遇到了什么瓶颈。"
独立审计(可选):如果成本允许,可以使用一个更小、更快的模型作为“监考老师”(Judge LLM),专门监控主模型的轨迹:
输入:Action History。
输出:
is_looping: boolean, reason: string。语义打破:当判定为循环时,强制清除缓存或注入一个“思维转折点”,引导模型从不同角度思考。
判定 Prompt 示例:
plaintext[历史轨迹片段] 第1步: 搜索 "Python 异步教程" -> 结果过长 第2步: 搜索 "Python 异步 简单" -> 结果不全 第3步: 搜索 "Python 异步 基础" -> 结果与第1步类似 [Judge 指令] 观察上述步骤,模型是否在原地踏步? 如果是,请输出 TERMINATE 并给出纠正建议。
追问 2:错误反馈塞回 LLM 后,LLM 还是搞错怎么办? 答题要点:靠最大步数和超时兜底;同时可以设计「错误连续次数」阈值(如连续 3 次工具失败),超阈值就走人工兜底(返回 fallback 文案 / 转人工 / 告知用户)。
追问 3:怎么避免 LLM 在错误反馈循环中烧 token? 答题要点:① 错误信息要简洁(不要把 stack trace 全塞);② 历史 messages 中过早的失败可以摘要化或剪枝;③ 设置
max_steps配合max_total_tokens;④ 极端情况切到一个更便宜的模型做兜底决策。追问 4:Function Calling 和 MCP 在错误处理上有什么区别? 答题要点:Function Calling 主要是模型输出工具调用的结构化机制,工具执行失败后的处理由宿主应用自行负责;MCP 则进一步规定了客户端与工具服务之间的标准通信协议,包括工具调用结果和错误响应格式,使不同 MCP Client 与 MCP Server 能以统一方式进行工具调用。Function Calling:重点解决“模型怎么调用工具”;MCP:重点解决“不同系统之间怎么标准化地使用工具”。
面试中如何回答
这道题考的是对 Agent 鲁棒性的理解 。回答时分三层:
重试层 :瞬态错误(网络超时、5xx)指数退避重试,确定性错误(参数错、401/403)不重试
决策层 :把详细、可操作的错误信息反馈给 LLM,让它重新规划 (换工具、改参数、放弃)
保护层 :最大步数、超时、循环检测,防止死循环
关键是不要自己硬编码「失败了怎么办」 ,而是让 LLM 根据错误信息自主决策,这才是 Agent 区别于死板自动化脚本的核心。能把错误信息写成「结构化 + 可操作」的形式(错误类型 + 原因 + 建议),并加一层兜底保护,这道题就稳了。