Appearance
Q82 · 如何设计 Python 代码解释器?
用户给售后分析助手一份订单表,问:“每种商品的已支付订单有多少笔、收入多少?请给我一份汇总 CSV。”大模型可以写出统计思路,但如果只靠它“心算”表格,可能把已退款订单也算进收入。于是应用让模型生成一小段 Python,拿真实文件运行,再查看程序输出和汇总文件。这里的关键问题是:**模型生成的代码不能直接在应用服务器上随意运行。**代码可能写错、卡住、读到其他客户文件,甚至试图联网传出数据。
工程上说的 Python 代码解释器,通常是一套受控执行工具:接收代码和输入文件,把它们放进隔离环境,限定资源和权限,运行 Python,收集标准输出、错误输出、退出状态与产物文件,检查结果后决定是回答、修正还是停止。Python 本身是语言与运行时;eval() 是执行表达式的内置函数。它们都不会自动提供任务级隔离、文件授权、资源预算、产物校验或审计。Python 官方文档明确警告,eval() 执行不可信输入会带来安全问题;subprocess 的超时与输出收集只负责进程管理,不能单独充当沙箱。Python eval() 文档、Python subprocess 文档
术语、文件和变量
| 名称 | 初学者先这样理解 | 本例中的含义 |
|---|---|---|
| Python / 运行时 | Python 是编程语言;运行时是执行代码的解释器与标准库 | 执行 analysis.py 的 Python 进程 |
| 代码解释器工具 | 应用提供的“运行代码并拿回结果”能力,不等于 Python 语言本身 | 给售后助手的受控分析工具 |
| 沙箱 / 隔离环境 | 只允许代码接触指定文件、网络与资源的运行场所 | 每次分析单独启动的受限容器或更强隔离单元 |
| stdout / 标准输出 | 程序正常打印的文字流 | print() 的“earphones: 2 单...” |
| stderr / 错误输出 | 程序写出的报错文字流;不保证所有错误都只在这里 | SyntaxError 或本例的 DATA_ERROR |
| 退出码 | 进程结束时给执行器的整数状态;通常 0 表示进程正常退出 | 0 表示脚本运行完,2 表示输入数据错误 |
| 产物(artifact) | 程序生成、可交给用户的文件 | output/summary.csv |
| 回合 / 修正 | 一次生成、执行、读反馈;失败后据反馈改代码再运行 | 修正一次 status 字段拼写错误 |
| 超时 / 资源预算 | 限制可运行多久、用多少内存/CPU/进程/磁盘/输出 | 例如按任务设置时限和输出上限,具体值由压测决定 |
| 只读挂载 / 可写区 | 只能看不能改的文件区 / 允许生成产物的文件区 | input/ 只读,output/ 可写 |
| 依赖 / 包环境 | 代码要用的 Python 库及其固定版本 | 本例仅用标准库 csv、decimal;生产镜像预装允许的包 |
orders.csv | 输入表格文件 | 四笔虚构订单,含一笔 refunded |
analysis.py | 本例要运行的脚本文件 | 读取输入,按商品汇总,写结果 |
INPUT_FILE / OUTPUT_FILE | 从环境变量读取的输入/输出路径;未提供时用示例默认路径 | input/orders.csv / output/summary.csv |
order_id / product / amount / status | 订单号 / 商品类型 / 金额 / 状态四列 | A104,earphones,200.00,refunded |
paid / refunded | 已支付 / 已退款,都是教学数据的状态值 | 只计 paid,排除 refunded |
totals / counts | 每种商品的收入之和 / 已支付订单笔数 | 耳机收入 200.00、2 笔 |
Decimal | 用十进制数表示金额,避免常见二进制浮点表示误差 | 把 CSV 的 120.00 转成金额再相加 |
本文的商品、金额与订单状态全是教学假设,不代表实际财务口径。输入文件和产物由应用侧在任务目录中准备、回收;模型只能看到被授权用于这次分析的数据。运行以下示例需本地 Python 3,且只应对这段已审阅的教学脚本本地运行;来自用户或模型的未知代码要进入后文所述沙箱。
从代码到结果的闭环
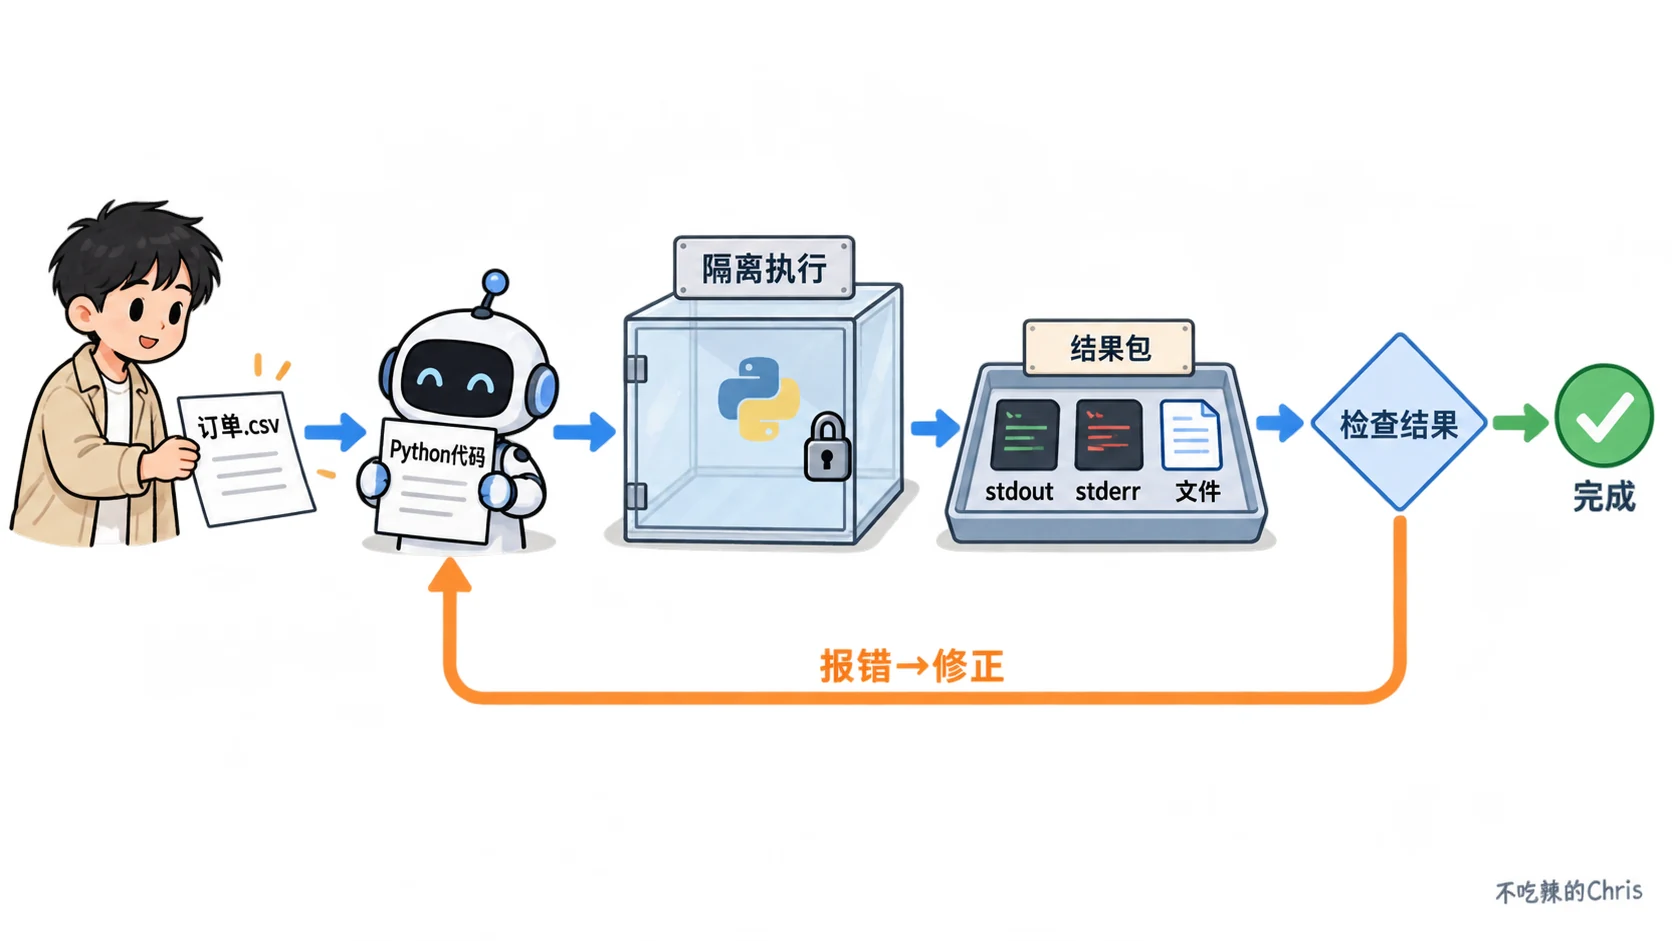
图中“结果包”装三种不同东西:stdout 是便于阅读的文字,stderr 是错误线索,文件是要交付的产物。它们都不是最终正确性的证明。检查结果要同时看退出状态、输出文件是否存在、文件格式与内容是否符合用户要求。橙色箭头表示可修正的代码错误返回生成环节;修正次数必须有上限,权限违规或资源耗尽不应当靠“再写一版代码”反复试探。绿色“完成”只在验证通过时走到。
一次典型流转如下:
- 接收任务与数据:应用确认用户有权分析这份
orders.csv,确定目标是“按product汇总status=paid的订单”,预期产物为 CSV。上传文件先做大小、类型和权限检查,再复制到单次任务的只读输入区。 - 生成代码:模型根据列名、少量脱敏样例和任务说明写
analysis.py。它可以提出需要哪些库,却不能自行在服务器安装任意包或读取未列出的目录。模型输出是候选代码,还未执行。 - 受限执行:调度器为这次任务创建隔离环境,放入候选代码和输入,设置用户身份、网络、文件挂载、时限与资源配额,启动 Python。执行器仅运行允许的命令与预装环境。Docker 资源限制、None 网络驱动
- 收集与校验:拿回退出码、截断后的
stdout/stderr、产物清单(文件名、大小、类型和校验值)。先判断是否超时、内存不足或权限被拒,再看业务结果:汇总文件是否只有paid、总数是否对得上输入。 - 修正或结束:若是
SyntaxError、列名写错等可修问题,在次数上限内把脱敏后的错误摘要给模型修正;若通过验证,就把结果文件与解释交给用户;若始终失败,报告具体失败点,保留追踪记录并停止。Pythonsubprocess输出与超时
一份能照着运行的订单分析
先看输入,四行订单里 A104 已退款,所以不能计入“已支付收入”。在一个空目录下建立 input 和 output,把下面内容保存为 input/orders.csv:
csv
order_id,product,amount,status
A101,earphones,120.00,paid
A102,earphones,80.00,paid
A103,keyboard,50.00,paid
A104,earphones,200.00,refunded
代码前把会用到的 Python 名字说清楚:csv.DictReader 逐行把 CSV 读成“列名 → 值”的字典;csv.DictWriter 按指定列写新 CSV;defaultdict 在第一次出现商品时给计数/金额一个零初值;Path 管理文件路径;os.environ.get 读取可选环境变量;print(..., file=sys.stderr) 把输入错误放进错误流。金额用 Decimal,避免直接把二进制浮点数当精确钱数。Python csv 文档、Python decimal 文档
把下面完整代码保存为 analysis.py:
python
import csv
import os
import sys
from collections import defaultdict
from decimal import Decimal, InvalidOperation
from pathlib import Path

INPUT_FILE = Path(os.environ.get("INPUT_FILE", "input/orders.csv"))
OUTPUT_FILE = Path(os.environ.get("OUTPUT_FILE", "output/summary.csv"))

totals = defaultdict(lambda: Decimal("0.00"))
counts = defaultdict(int)

try:
    with INPUT_FILE.open("r", encoding="utf-8", newline="") as source:
        reader = csv.DictReader(source)
        required = {"order_id", "product", "amount", "status"}
        if not required.issubset(reader.fieldnames or []):
            raise ValueError("missing required CSV columns")

        for row in reader:
            if row["status"] != "paid":
                continue
            product = row["product"]
            amount = Decimal(row["amount"])
            counts[product] += 1
            totals[product] += amount

    OUTPUT_FILE.parent.mkdir(parents=True, exist_ok=True)
    with OUTPUT_FILE.open("w", encoding="utf-8", newline="") as target:
        writer = csv.DictWriter(
            target, fieldnames=["product", "paid_orders", "revenue"]
        )
        writer.writeheader()
        for product in sorted(counts):
            writer.writerow({
                "product": product,
                "paid_orders": counts[product],
                "revenue": f"{totals[product]:.2f}",
            })

    for product in sorted(counts):
        print(f"{product}: {counts[product]} 单, {totals[product]:.2f}")
    print(f"TOTAL: {sum(counts.values())} 单, {sum(totals.values()):.2f}")

except (FileNotFoundError, KeyError, InvalidOperation, ValueError) as error:
    print(f"DATA_ERROR: {error}", file=sys.stderr)
    raise SystemExit(2)
在该目录运行 python3 analysis.py。本例标准输出应为:
text
earphones: 2 单, 200.00
keyboard: 1 单, 50.00
TOTAL: 3 单, 250.00
output/summary.csv 应为:
csv
product,paid_orders,revenue
earphones,2,200.00
keyboard,1,50.00
逐行追一下数:A101 与 A102 的 status 都是 paid,耳机计数从 0 到 2,金额由 0.00 加到 200.00;A103 让键盘计数为 1、金额为 50.00;A104 是 refunded,遇到 continue(跳过本轮)便不进入任何合计。sorted(counts) 固定输出顺序,便于校验。OUTPUT_FILE.parent.mkdir 只创建结果目录;生产执行时该目录必须落在沙箱允许的可写区。raise SystemExit(2) 在输入不合法时以退出码 2 停止,执行器能把它与成功退出区分开。
这个脚本确实可本地运行,但它只是被允许的分析逻辑示例,不是通用安全执行器。比如如果模型把过滤条件错写为“所有非空状态”,脚本仍可能退出码为 0、还生成 summary.csv,却会把 A104 的 200.00 错算进去,得到 450.00。因此退出码 0 只说明 Python 正常结束;业务层还需校验行数、状态过滤、总额或抽样原始记录,才可宣告完成。
真正的执行器把哪些东西隔离起来
输入、代码和产物的方向必须固定。应用为每次任务创建独立目录:代码文件只读、经授权的输入文件只读、输出目录可写,其他主机路径不挂进去。容器根文件系统也尽量只读,临时文件只放进大小受控的临时区。容器应以非特权用户运行,丢弃不需要的权限,不挂 Docker socket、宿主机凭证或私有目录。Docker 的只读 bind mount 文档说明了输入只读挂载;seccomp 文档说明系统调用限制属于纵深防护。“放进容器”四个字不等于完全安全:具体风险取决于宿主配置、内核、挂载、凭证和多租户威胁模型;不可信或高敏场景还应评估更强的虚拟机级隔离与专门审计。
**网络默认关闭。**本例只读本地 CSV,无需外网,因此可用无网络环境。Docker 官方 --network none 仅创建回环网络,不提供外部连通性。若用户确实要求查公开资料,也不要让生成代码直接拿生产凭证任意联网;由宿主侧受控工具按域名、身份和数据范围拉取,再把允许的数据送入沙箱,或使用经过审查的网络代理。Docker None 网络驱动
资源限制要多维度。墙钟时间限制一项任务等多久;CPU 与内存限制代码能占多少计算资源;进程数限制避免无限创建子进程;磁盘/临时区和产物个数、单文件大小限制避免写满磁盘;stdout/stderr 字节上限避免循环 print() 撑爆日志或模型上下文。Docker 官方文档提供 CPU、内存等限制,但具体数值需要按允许的数据规模与压测设置。外层调度器还需有任务超时和清理逻辑,防止仅杀了等待进程却留下仍在运行的容器。Python subprocess.run(..., timeout=...) 可在等待子进程时处理超时;这并不替代容器层资源限制或服务端任务生命周期管理。Docker 资源约束、Python subprocess 超时
**包环境固定。**本例只用标准库,便于复现。若任务需 pandas、绘图包等,可在经过审查的镜像中预装、锁定版本,并记录镜像不可变标识;不要允许生成代码在执行时随意 pip install、下载脚本或改基础环境。代码能否导入某包应由任务说明与镜像清单决定;缺包是明确的环境错误,不能让模型通过联网安装来“自我修复”。升级包或 Python 版本后应重跑分析样本,尤其是数值与文件格式校验。
**执行接口只收数据,不让模型拼 Shell。**模型可以提交 code、输入文件引用和希望输出的文件类型;服务端验证请求后,自己构造固定命令参数,例如调用已选 Python 解释器运行指定脚本。不要把模型字符串直接拼进 shell=True 命令,也不要用 Python eval() / exec() 在主应用进程里执行。即使禁了 import os,黑名单或静态扫描也不能代替真正的权限隔离;Python 官方文档指出 eval() 对不可信输入有安全风险。Python eval() 文档、Python subprocess 安全考虑
报错、修正与停止不能只靠模型感觉
执行器应该给上层返回一个稳定的数据对象,字段如 exit_code、timed_out、stdout_excerpt、stderr_excerpt、artifacts、resource_usage、run_id。其中 artifacts 只列被允许的输出区内、通过大小与文件类型检查的文件;目录外链接、符号链接、超大文件和可执行文件不能直接展示或下载。run_id 是追踪这次执行的编号,便于将生成代码、容器配置和产物对应起来。把截断后的错误摘要交给模型修正时,要先去掉路径中的私密信息、凭证和用户原始数据。
| 执行结果 | A101–A104 例中的可能原因 | 上层应怎样处理 |
|---|---|---|
| 退出 0,产物也通过业务校验 | 只算三条 paid,总额 250.00 | 交付 summary.csv,说明过滤条件 |
SyntaxError 或列名拼错 | 模型写成 row["payment_status"],CSV 只有 status | 在修正次数内给模型精简报错和列名,再隔离执行;仍失败则停 |
| 输入文件不存在或列缺失 | 上传失败,或用户给的 CSV 没有 amount | 明确要求补文件或确认列映射,不猜金额 |
| 超时、内存不足、输出过大 | 代码死循环、一次读入超大表,或无限打印 | 终止并清理,报告资源失败;缩小任务或人工排查,不无界重跑 |
| 权限/网络被拒 | 代码试图读未授权目录或访问外网 | 保留安全事件,不通过提示词叫模型绕过限制 |
| 退出 0,但结果是 450.00 | 错把 refunded 也计入 | 判业务校验失败;可在有限回合内修正过滤逻辑 |
| 产物格式或类型不对 | 生成 HTML 或空文件,用户要的是 CSV | 判未完成,检查写入路径和内容 |
修正回合要有明确上限,例如本例最多两次;这只是教学预算,真实值由延迟和错误率决定。每轮都从原始只读输入的干净环境启动,不沿用上轮代码留下的文件或进程。修正后再次做相同的资源限制与结果校验。若代码试图越权读文件、联网或执行其他不允许的动作,应停止并按安全事件处理;不能把“多试几次直到成功”当修复。若只是列名错误,给模型 stderr 里的错误类别和允许的列名通常足够,不必把整份订单表、系统路径和环境变量回传。OpenAI Agent 工具执行与评估文档
结果验证分三层:技术层看进程退出、资源与产物格式;数据层看文件行数、金额数值、状态过滤和来源对应;业务层看回答是否符合用户目标、权限和隐私要求。A104 是检验“是否误算退款”的关键反例。若用户上传的数据本身金额缺失,就应报告无法给出准确总额,而不是生成一个整齐但错误的表。
审计与回收:能追溯,又不把数据泄露出去
一条执行记录至少要关联:用户与任务 ID、代码版本/哈希、输入文件清单与哈希、镜像标识、预装包版本、网络与文件权限配置、资源上限、开始结束时间、退出码、错误类别、截断后的标准输出/错误输出、产物清单与校验结果。代码本身和输出可能含敏感信息,日志要按权限访问、脱敏与保留期限管理;不需要为了审计把所有原始订单与完整 stderr 永久存下来。
任务结束后应终止容器、回收临时空间、按约定保留可下载产物,过期删除。若进程超时或服务重启,清理程序也要能识别遗留运行单元。对于用户反复运行同一分析,要使用独立任务目录和可追溯版本,不让一次运行修改另一份输入。产物交给用户前按文件类型与大小做检查,避免把模型写出的脚本、敏感环境文件或恶意内容当“分析结果”提供下载。
面试时怎样回答
我会把 Python 代码解释器设计成一个受控工具,而不是在应用进程里直接
eval模型代码。流程是:模型根据任务和授权数据生成候选脚本;调度器把代码与只读输入放进隔离环境,关闭不需要的网络,限制文件、用户权限、时间、CPU、内存和输出;运行后收集退出码、stdout、stderr与产物文件;再按格式和业务结果验证。像订单汇总要确认只统计已支付行,退出码为 0 还不够。可修的语法或列名错误最多重试有限回合,越权、超时和资源异常要停下来;最后记录运行配置与产物,回收沙箱。容器配置是防护的一层,高敏多租户场景还要评估更强隔离。
如果追问“直接用 eval() 执行模型生成的 Python 不就行了吗”,可以答:eval() 主要处理表达式,既不能承担这类完整脚本和文件产物的工作流,也没有安全隔离;执行不可信内容会危及主进程。若追问“stdout 显示 250.00 是不是就完成”,应答:还要核对生成的 CSV、过滤条件和输入行,且确认没有越权或隐藏的额外副作用。若追问“代码错了就无限自修复?”,应说明每次重试有成本与风险,必须限定次数并区分普通语法错误与安全违规。
资料依据
- Python:
subprocess——进程退出、stdout/stderr、超时与 Shell 使用边界。 - Python:
eval()——不可信输入执行风险;Python:csv与decimal——示例分析所用标准库。 - Docker:资源限制、无网络模式、只读挂载与seccomp——受限执行配置的官方依据。
- OpenAI:Evaluate agent workflows——用工具轨迹和结果检查 Agent 运行。