Appearance
Q6 · 什么是 LangChain?LangChain 包含哪些核心概念?
难度 P0 必背 · 岗位 算法 / 应用 · 预计阅读 9 min 关键词 langchain · lcel · chain · memory · retriever · agents
假设一个应用要把用户问题交给模型,并在回答前检索文档、整理提示词、解析输出。把这些步骤直接写在一大段业务代码中也能运行,但更难替换模型或单独检查某个环节。LangChain 提供一组组件及组合方式,帮助组织这条处理链。
先认清几个词
| 词 | 含义 | 在文档问答例子里 |
|---|---|---|
| Model | 接收输入并产生回复的模型接口 | 根据文档片段回答问题 |
| Prompt | 组织任务、资料和问题的输入 | 指明只根据检索资料回答 |
| Retriever | 根据问题查找相关资料的组件 | 找到文档片段 |
| Chain / Runnable | 可连接的处理步骤 | 将检索、提示词、模型串起来 |
| LCEL | LangChain 的组件表达式写法 | 用 ` |
| Memory | 对话状态的保存与取用方式 | 带入必要的历史问题 |
| Agent | 可根据结果选择下一步动作的系统 | 资料不足时继续查询 |
prompt | model | parser 中的 | 表示数据从左侧步骤传给右侧;parser 是把模型回复整理为应用可用结果的处理器。它不是 Shell 管道,具体输入输出仍取决于各组件的接口。
组件如何组成一条处理链
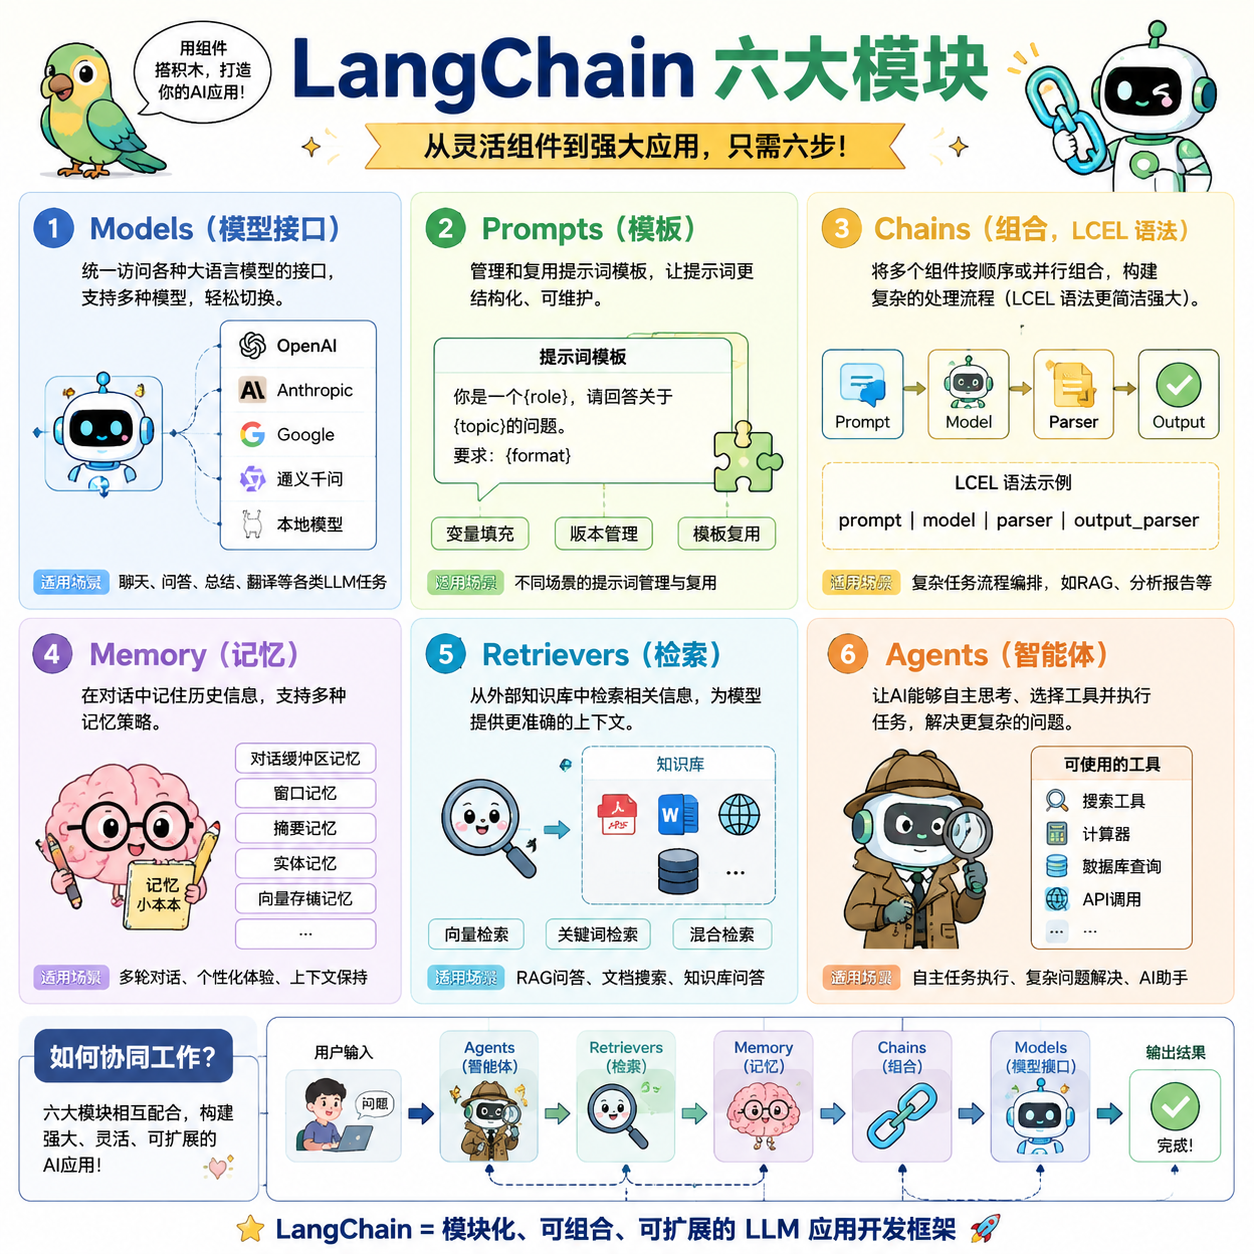
逐步拆开看
LangChain 我理解是 LLM 应用的「操作系统」 ——它提供了一套标准化的组件和抽象,让开发者能够快速构建复杂的 LLM 应用,同时保持灵活性和可替换性。
核心概念六大模块:
Models :统一的大模型调用接口
Prompts :提示词模板管理
Chains :组件链式组合(LCEL 语法)
Memory :对话记忆管理
Retrievers :文档检索(RAG 基础)
Agents :智能体自主决策
LangChain 的核心价值:抽象层
直接调 OpenAI API 很简单:
python
import openai
response = openai.chat.completions.create(...)
那为什么还需要 LangChain?三个核心价值:
1. 标准化接口
不同厂商的模型 API 格式不同,LangChain 提供统一接口,随时可以换模型不用改业务代码 。
python
from langchain.chat_models import ChatOpenAI, ChatAnthropic, ChatGoogle

# 这三个可以无缝替换
llm = ChatOpenAI(model="gpt-5.5")
llm = ChatAnthropic(model="claude-4.7")
llm = ChatGoogle(model="gemini-3.1pro")

# 调用方式完全一样
result = llm.invoke("你好")
业务代码不变,只换一行 import 就能切换模型。这在多厂商兼容、A/B 测试模型、降级备选场景中价值很大。
2. 组件化 + 可组合
把 LLM 应用拆成独立组件(Prompt、LLM、Memory、Retriever),用管道符 | 自由组合。每个组件遵循 Runnable 协议 (统一接口 invoke、stream、batch、ainvoke 等),任意组合都能跑。
3. 生态集成
和向量数据库(Pinecone、Milvus、Chroma、Weaviate)、文档加载器(PDF、Word、网页)、Agent 工具生态无缝集成。生态是 LangChain 最大的护城河 — 你想用哪个组件,往往已经有现成的封装。
LCEL:LangChain 的链式语法
LCEL(LangChain Expression Language) 是 v0.1 之后的新语法,用管道符 | 连接组件,类似 Unix 的 pipe:
python
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser

# ↓ 步骤 1:定义组件
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个{role}专家"),
    ("human", "{question}")
])
llm = ChatOpenAI(model="gpt-5.5")
parser = StrOutputParser()

# ↓ 步骤 2:链式组合(LCEL 核心)
chain = prompt | llm | parser

# ↓ 步骤 3:调用
result = chain.invoke({
    "role": "医疗",
    "question": "头痛可能是什么原因?"
})
这条链按 prompt | llm | parser 从左到右执行:prompt 把 role 和 question 填入消息模板,llm 根据消息生成内容,parser 再把模型输出转换为字符串。最终返回的是解析后的回答,而不是中间的消息列表。
LCEL 的好处:
组合性强 :任意 Runnable 都能用
|串起来流式天然支持 :
chain.stream()自动逐 token 流式输出并行/批量 :
RunnableParallel并行多分支、chain.batch()批量推理可观测 :每个节点输入输出都能记录、调试
旧版的 LLMChain.run() 已经被官方标记为 deprecated,新代码必须用 LCEL ,面试时强调这一点很加分。
六大核心组件详解
1. Models(模型)
统一的 LLM 调用接口,支持 OpenAI、Anthropic、本地模型等。
python
from langchain_openai import ChatOpenAI
from langchain_anthropic import ChatAnthropic

llm = ChatOpenAI(model="gpt-5.5", temperature=0.7)
支持 invoke / stream / batch / async 四种调用模式,统一接口。
2. Prompts(提示词)
模板化管理,支持变量插值、消息格式化。
python
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是{role}助手"),
    ("human", "{question}"),
    ("ai", "让我查一下..."),  # 预设的 AI 回复占位
])
进阶用法:FewShotPromptTemplate(动态少样本)、PipelinePromptTemplate(多模板组合)。
3. Chains(链)
组件的组合方式,LCEL 让链的定义变得极其简洁 。
4. Memory(记忆)
Memory 负责让 Agent 保存和利用历史信息 ,解决“当前上下文之外的信息如何持续保留”的问题。
新版 LangChain 更推荐基于 LangGraph 的 State + Checkpointer + Store 来实现记忆,而不是使用早期的 ConversationBufferMemory、ConversationSummaryMemory 等传统 Memory 类。
两类核心记忆
- 短期记忆(Short-term Memory)
保存当前对话 / 当前任务 的状态,例如:
最近的聊天消息
当前任务进度
工具调用结果
Agent 当前状态
通常通过 State + Checkpointer 实现。
新消息先写入当前任务的 State;任务推进时持续更新 State,Checkpointer 在指定时机保存快照。下次继续同一任务时,系统从快照恢复,不需要只靠模型“回忆”进度。
适合:多轮对话、任务暂停后继续执行等场景。
- 长期记忆(Long-term Memory)
保存跨会话仍然需要使用的信息 ,例如:
用户偏好
用户基本信息
历史经验
长期任务数据
通常通过 Store 持久化保存,需要时再读取;如果数据量大,也可以结合向量检索实现语义搜索。
值得跨会话保留的信息写入 Store。新会话需要它时,程序先检索相关记录,再把选中的内容放进这次 Agent 的上下文;Store 中的全部内容不会自动进入模型输入。
适合:跨会话记忆用户信息、长期知识积累等场景。
记忆的本质
短期记忆 = 记住“这次任务进行到哪了”长期记忆 = 记住“以后还可能用到什么”
两者保存的范围不同:State + Checkpointer 记录当前任务怎样继续,Store 保存以后其他会话仍可能用到的信息。前者回答“做到哪一步”,后者回答“哪些信息值得下次再取”。
即:新版 LangChain/LangGraph 的 Memory,不再只是“保存聊天记录”,而是通过 State 管理当前任务状态,通过 Checkpointer 持久化短期状态,通过 Store 管理跨会话长期记忆。
5. Retrievers(检索器)
Retriever 是 RAG 中负责“检索相关知识”的组件 ,根据用户问题,从外部知识源中找到与问题相关的文档或文档块(Chunk),再交给 LLM 生成答案。
注意:Retriever 不等于“向量数据库”。向量检索只是 Retriever 的一种常见实现,也可以使用关键词、BM25、混合检索等方式。
基础用法:向量检索
python
from langchain_community.vectorstores import Chroma

retriever = Chroma.from_documents(
    docs,
    embeddings
).as_retriever(
    search_kwargs={"k": 4}
)

# 根据问题检索最相关的 4 个文档块
results = retriever.invoke("什么是 RAG?")
在这个例子里,Retriever 接收用户问题,按向量相似度找出前 k 个相关文档块;应用再把这些文档块作为参考资料交给 LLM。检索结果是资料,不是模型已经核实的最终答案。
k=4 表示返回 4 个检索结果 ,通常是切分后的文档块(Chunk),不一定是 4 篇完整文档。
常见进阶 Retriever
MultiQueryRetriever :一个问题生成多个不同角度的查询,再分别检索,提高召回率,减少因为问题表达方式不同导致的漏召回。
ContextualCompressionRetriever :先进行正常检索,再对检索结果进行过滤或压缩,只保留与当前问题真正相关的内容,减少无关上下文。
ParentDocumentRetriever :用较小的 Chunk 进行检索,提高检索精度;检索命中后返回对应的较大父文档,兼顾检索精度和上下文完整性 。
Retriever 解决的是“从知识库里找什么”;不同 Retriever 的区别,本质上是“用什么策略把相关知识找出来”。
基础 RAG:向量检索;复杂 RAG:可以进一步使用 Multi-Query、Contextual Compression、Parent-Child 等策略优化检索效果。
6. Agents(智能体)
自主决策的 Agent,可以调用工具、循环执行。
python
from langchain.agents import create_openai_tools_agent

agent = create_openai_tools_agent(llm, tools, prompt)
result = agent.invoke({"input": "查一下北京天气"})
LangChain 经典 Agent:ReAct Agent、OpenAI Tools Agent、Structured Chat Agent。新趋势是迁移到 LangGraph (基于状态机的 Agent 编排框架),适合复杂多 Agent 协作。
使用 LangChain 时容易踩的坑
踩坑 1:还在用旧版 .run() / LLMChain
错误描述 :示例代码用 LLMChain(llm=llm, prompt=prompt).run(...)。
正确做法 :旧版 API 已被官方标记 deprecated,必须用 LCEL prompt | llm | parser。
踩坑 2:把 LangChain 当万能框架,简单场景也硬上
错误描述 :「我所有 LLM 项目都用 LangChain」。
正确做法 :LangChain 抽象层多,简单场景(单次调用、固定流程)直接调原生 SDK 更轻量、更易调试。LangChain 的价值在于复杂场景 :多模型切换、复杂 Agent、生态组件集成。简单场景上 LangChain 是过度工程。
踩坑 3:忽视版本兼容性
错误描述 :「网上抄一段 LangChain 代码就能跑」。
正确做法 :LangChain 在 v0.1 / v0.2 / v0.3 之间有重大重构,包名、API、Memory 等都有变化。新代码使用 langchain_core、langchain_openai 等独立子包,不要用大杂烩 from langchain.xxx。
踩坑 4:Agent 用 ReAct 但没设最大步数
错误描述 :AgentExecutor(agent=agent, tools=tools) 直接跑。
正确做法 :必须设 max_iterations 和 max_execution_time,否则 LLM 会无限循环。
踩坑 5:把 LangChain 和 LangGraph 搞混
错误描述 :「LangGraph 是 LangChain 的子模块吗?」
正确做法 :LangGraph 是 LangChain 团队推出的独立框架 ,专做有状态、循环、多 Agent 编排,更接近状态机。LangChain 现在的定位是「组件层」,LangGraph 是「编排层」。复杂 Agent 优先选 LangGraph。
再往下追问时怎么解释
- 追问 1:LCEL 怎么实现并行? 答题要点:用
RunnableParallel,把多个 chain 同时跑,结果合并成 dict。例如RunnableParallel(summary=summary_chain, keywords=kw_chain).invoke(text)会并行得到{summary, keywords}。底层用 asyncio 加速。
- 核心工具:
RunnableParallel在 LCEL 中,如果你用
|(管道符)连接组件,它们是串行的(上一个的输出是下一个的输入)。 而RunnableParallel是一个并行分叉器。
它的作用:它会把输入数据(比如一段长文本)同时分发给多个不同的 Chain。
它的结构:通常以字典 (Dict) 的形式定义,Key 是你给任务起的名,Value 是具体的 Chain。
- 具体怎么运行?(以代码为例)
假设你有两个任务:一个生成摘要,一个提取关键词。
pythonfrom langchain_core.runnables import RunnableParallel from langchain_core.prompts import ChatPromptTemplate # 1. 定义两个独立的 Chain summary_chain = ChatPromptTemplate.from_template("请简述:{text}") | llm kw_chain = ChatPromptTemplate.from_template("提取关键词:{text}") | llm # 2. 使用 RunnableParallel 把它们捆绑在一起 map_chain = RunnableParallel( summary=summary_chain, keywords=kw_chain ) # 3. 一次调用,同时触发 result = map_chain.invoke({"text": "这是一段很长的测试文本..."}) # 4. 结果会自动合并成字典 # result = {"summary": "...", "keywords": "..."}
追问 2:LangChain 的 Runnable 协议是什么? 答题要点:所有组件都遵循
invoke / batch / stream / ainvoke / abatch / astream六个统一接口。这就是为什么prompt | llm | parser能任意组合 — 因为它们都是 Runnable,输入输出契约统一。追问 3:LangChain 和 LlamaIndex 有什么区别? 答题要点:① LangChain 偏 Agent 与编排 (Chain/Agent/Tool)② LlamaIndex 偏数据接入与 RAG (Index/Retriever/Query Engine)③ 实际生产中两者经常混用:LlamaIndex 做数据层,LangChain 做应用层。
追问 4:LangChain 在生产中常踩的坑是什么? 答题要点:① 抽象层多导致调试困难(一层套一层很难定位问题)② 版本变动频繁(v0.1/v0.2/v0.3 大改)③ token 不可控(每个组件都可能加 prompt)④ 异步支持不够好(早期)。生产建议:核心链路用 LCEL(清晰)、复杂逻辑下沉到自己代码(可控)、设 token 上限。
追问 5:什么时候不该用 LangChain? 答题要点:① 单次简单调用 — 直接用 SDK;② 对延迟极度敏感的场景 — LangChain 抽象层有开销;③ 完全自主可控的生产系统 — 自己写胶水代码反而更可控;④ 低代码场景 — 用 Dify / Coze 等平台更高效。
面试中如何回答
面试回答 LangChain,强调三点 :
核心价值 :标准化接口(可替换模型)、组件化(可组合)、生态集成
现代语法 :LCEL 用
|管道符连接组件,比旧版.run()更简洁,面试必谈六大模块 :Models / Prompts / Chains / Memory / Retrievers / Agents
一个加分点是能说出 LangChain 的局限性 :抽象层太多有时候反而增加复杂度,简单场景直接调 API 可能更合适;新趋势是 LangGraph(编排层)+ LangChain(组件层)的双层架构。
再补一句「LangChain 的护城河是生态 — 几乎任何向量库 / 文档加载器 / Agent 工具都已有现成集成」,这道题就稳了。