Appearance
Q137 · 什么是 MMLU?如何解读 MMLU 分数?
选两个大语言模型时,你可能看到一张表写着“模型甲 MMLU 82,模型乙 MMLU 80”。这两个数字看起来像考试分数,但先得弄清:它们是不是做了同一套题、每题给了多少示例、怎样从模型输出选出答案,以及“82”究竟按什么方式汇总。若这些条件不同,直接比较两个数字就像把开卷考试和闭卷考试的成绩排在一起。
MMLU 是 Massive Multitask Language Understanding 的缩写,可理解为“大规模多任务语言理解”测试。原版 MMLU 收集 57 个学科的选择题,横跨数学、计算机科学、历史、法律、医学等领域,用同一套评测流程观察模型在广泛知识与推理题上的表现。它衡量的是在规定题目和答题协议下选对标准答案的比例,不能直接读成“模型在真实世界有 82% 的概率可靠地完成任何任务”。这一范围与原论文、作者数据及评测代码一致。MMLU 原论文 · 作者发布的题集与评测代码
术语与符号
| 词或记号 | 含义 | 下文的小成绩单对应什么 |
|---|---|---|
| 基准测试(benchmark) | 预先准备的题目和评分规则,用相同方式测不同模型 | 一份固定的四选一试卷及其答案表 |
| 学科 / 任务(subject / task) | 题目所属领域;MMLU 原版共有 57 个 | 示例中的数学、历史、法律三科 |
| 题目样本 | 一道待作答的问题、四个选项和标准答案 | “数学 8 道题”中的任意一道 |
| 评测协议 | 给模型什么输入、允许看多少示例、怎样取答案和算分的约定 | 示例是否先给答过的题、是否按 A/B/C/D 取最大概率 |
| 零样本(zero-shot) | 不先展示已作答的同类示例,直接让模型答测试题 | 直接给一道数学题让模型选 |
| 少样本(few-shot) | 在测试题前放少量已作答示例,帮助模型识别题型和输出格式 | 先展示几道数学例题及答案,再给测试题 |
| 5-shot | 每道测试题前最多放 5 道同学科已作答示例的常见原版设置 | 相当于考前看 5 道样题;样题不是要计分的测试题 |
| 正确率(accuracy) | 答对题数 ÷ 参与计分题数 | 22 道答对、共 40 道,则为 55% |
| 随机基线 | 不会做题、在四个选项间均匀乱猜时的期望正确率 | 四选一为 25%;不是每次必得 25% |
| 按题汇总(微平均) | 先汇总所有题的对错,再除以总题数;题多的学科权重大 | (6+6+10)/(8+12+20)=55% |
| 按科汇总(宏平均) | 先算各科正确率,再把各科等权平均 | (75%+50%+50%)/3≈58.33% |
| 测试集污染 | 测试题或答案进入训练、调参、提示词设计等过程,导致分数不能代表未见题的表现 | 考前已经看过要考的题和答案 |
这里的 shot 是“给几个已解答的示例”,不是模型生成了几次答案;“准确率”说的是这份题集上的命中率,不是模型自报的信心,也不是每次回答都正确的承诺。
一道题从输入到计分怎样走
原版每道题有一个问题、A/B/C/D 四个选项和一个标准答案。以教学用的虚构题为例:“某历史事件发生在哪一年?”后面列四个年份。如果答案表标 C,模型选 C 算 1 道正确,选 A、B 或 D 算错误;答得很有说服力但选错,也不能按这套规则拿分。实际题目与学科来自作者公开的数据集,教学题不属于正式 MMLU。作者数据仓库
作者的评测实现默认参数 ntrain=5:从同一学科的开发集取已知答案的示例,排在待测题前;提示词还说明这是某学科的选择题。程序随后比较模型给 A、 B、 C、 D 四个候选答案的分数,取得分最高者为预测,再与标准答案比对。这里 ntrain 只是“最多放多少道示例题”的代码参数名;开发集示例用于构造输入,测试题才进入最终计分。若完整提示词超过模型能容纳的长度,作者代码会减少示例数,因此实际并非每道题都必然放足 5 道。原论文的评测设置 · 作者的 evaluate.py
这描述的是原论文及作者脚本的一种具体协议。后来的评测平台可能让模型生成一整段文字,再从中解析 A/B/C/D;也可能允许思维链、不同数量的示例或不同提示模板。即使题目相同,答案提取方式变化也可能改变成绩。看见“5-shot MMLU”时,应继续问具体使用了哪版题集、提示词、答案提取和汇总方法。
用一张小成绩单读懂总体分数
假设我们只抽出三个虚构学科、共 40 道四选一题。以下数字仅用于算分教学,不是某个模型的真实 MMLU 结果:
| 学科 | 答对 / 总题数 | 单科正确率 |
|---|---|---|
| 数学 | 6 / 8 | 75% |
| 历史 | 6 / 12 | 50% |
| 法律 | 10 / 20 | 50% |
| 全部题目 | 22 / 40 | 55% |
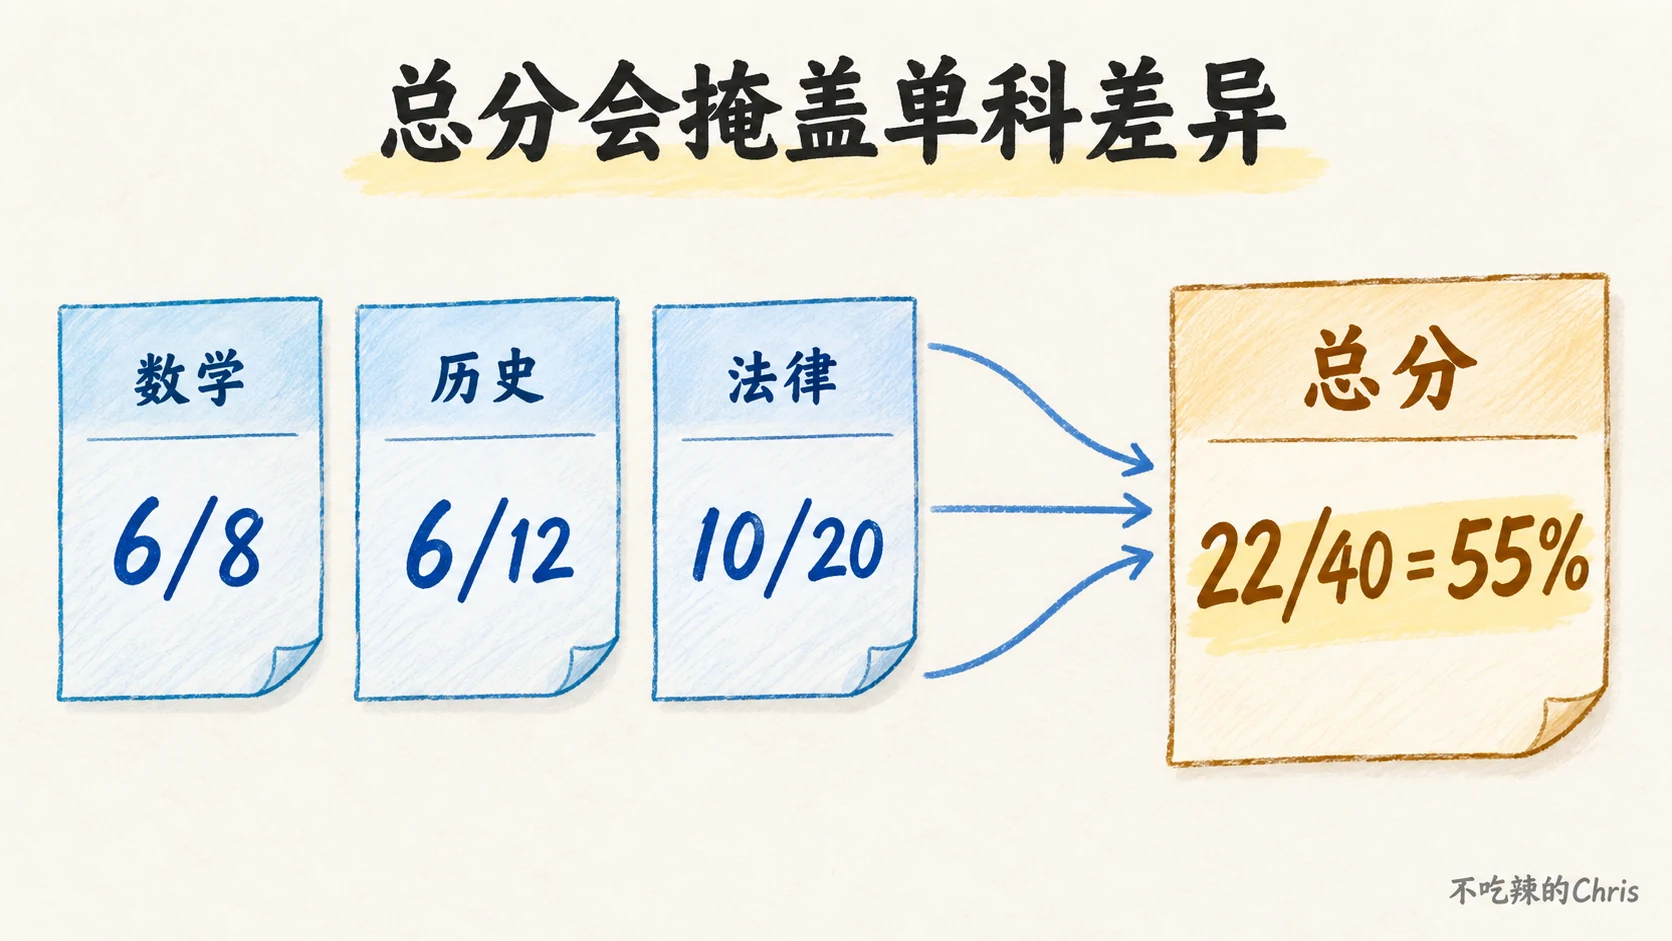
图中的箭头表示把三个学科的答对数和题目数分别相加:6+6+10=22,8+12+20=40,所以总体按题正确率为 22÷40=55%。作者脚本的总体 weighted_acc 也是先把各科测试题的对错串起来,再求平均;学科题数不同,其对总分的贡献也不同。作者评测脚本
如果换成“每个学科都占三分之一”的宏平均,结果则是 (75%+50%+50%)÷3≈58.33%。**55% 和 58.33% 都是对这张成绩单的合法描述,但回答的问题不同。**前者问“所有题里答对多少”,后者问“平均一个学科的正确率是多少”。论文和表格若只给一个数字、没说明汇总口径,就无法严谨复现。原论文主要报告按题数加权的总体准确率,也分别展示学科类别与具体学科的成绩。MMLU 原论文
在四个选项等概率且彼此不知道答案的前提下,乱猜一题答对的概率为 1÷4=25%。40 道题随机猜,期望答对 40×25%=10 道;某一次可能不是正好 10 道。示例中的 22 道高于这个基线,但不能据此推断模型“理解了所有法律知识”;它在法律科只答对一半。把 55% 与 25% 相减,得到 30 个百分点的差距;不要误写成“提高了 30%”。作者仓库的随机基线
分数能支持什么结论,不能支持什么结论
在相同题集和协议下,更高的 MMLU 正确率支持一个有限结论:该模型在这套覆盖多个学科的选择题上,选中标准答案的比例更高。它对观察通识知识和某些推理能力有用,但单一数字会压平许多差异。
**单科差异。**上例数学 75%、法律 50%,总分 55%。如果应用实际要处理法律资料,总分远不如相关子学科成绩和业务题集有用。原论文也逐科报告结果,正是因为不同学科表现可能悬殊。MMLU 原论文
**答题形式差异。**四选一让模型从已有选项中辨认答案;真实任务可能要求它查资料、引用来源、写代码并运行、与工具交互、承认不知道或处理模糊指令。MMLU 分数本身没有测完这些动作。一个模型可能在选择题上很好,却在“给出可追溯来源”上失败;反过来,选择题的固定选项也限制了它展示解释能力的空间。这是从测试设计推得的适用边界,并非说 MMLU 无价值。
**语言和场景差异。**原版题目及作者英文提示词测的是英语环境下的这套学科题,不能把同一分数直接当作中文客服、中文法律文本或某个行业实际任务的正确率。如果目标产品用中文,应另建中文、行业和流程级评测。一个中文改写或翻译版本也要标明其数据与协议,不能无条件写成原版成绩。作者提示词与数据
**训练数据与公开题集。**测试题公开后,模型训练材料、检索资料、针对题集的调参或提示词选择都可能接触到题目。若模型记住题目,分数会高估它对未见问题的泛化能力;但仅凭一个高分也不能断定某模型一定受污染。评估时应记录训练数据排查与去重办法,并用未公开或新收集的题目补测。数据污染研究说明了公开基准存在的这种风险。数据污染研究原论文
**接近满分时的解释空间。**高分并不等于“几乎没有风险”。剩余错题可能集中在业务最重要的领域,答错后果也可能远高于答对的收益。选择模型时应同时看目标领域子集、错误类型、校准与业务流程测试,而不是只在排行榜上取最高数。
比较两个模型前,先对齐哪些条件
设模型甲报告 82、模型乙报告 80。若甲使用五个已答示例、乙直接零样本,差异可能部分来自输入信息;若甲允许生成推理过程,乙只能预测单个选项,两者也不是同一种答题方式。比较时至少核对:
- **题集与版本:**是不是同一份原版 MMLU 测试集,是否删题、重采样、翻译或混入其他版本;
- **提示与示例:**零样本还是 few-shot、实际示例数、示例来源、提示词模板、上下文过长时怎样截断;
- **答题规则:**比较四个选项的模型分数,还是生成文字后解析;是否允许思维链、外部工具或检索;
- **计分口径:**按题汇总还是按科平均,是否把无效或无法解析的答案算错,是否报告各科结果;
- **评测独立性:**是否用测试题调过提示词、筛选过模型或训练数据,模型版本与评测日期是什么。
条件对齐后,仍要看差距是否稳定:换几种合理提示、查看各科错题,确认“高两分”不是某种格式或抽样偶然性带来的假象。原版 MMLU 的作者脚本提供可复核的具体实现,但不同榜单未必完全沿用它。作者评测脚本
原版 MMLU 与 MMLU-Pro 不能混成一项
名字相近的 MMLU-Pro 是后续提出的另一套更难、强调推理的基准。其论文说明,它调整了题目、把每题选项从原版的 4 个扩展到 10 个,并使用自己的分类与评测设计。十选一均匀乱猜的期望基线是 10%,原版四选一是 25%;两个分数的题目难度、题目集合和协议也不同。因此“原版 80、Pro 70”不能读成同一张试卷退步了 10 个百分点,更不能只按数字高低判断模型优劣。报告必须完整写出基准名称和版本。MMLU-Pro 原论文 · MMLU-Pro 作者仓库
一次常见的评测失败怎样发现
团队按五样本协议测试新模型,得出“法律科 95%”,于是准备把它接进法律问答。复核时发现构造提示词的程序从全部题目里抽了示例,其中混入了待测题或其答案。模型相当于先看到了考题,95% 不能作为独立测试成绩。处理办法是明确分开开发集与测试集,逐题检查示例 ID 不得与待测题重合,排查训练与检索材料中是否有公开题,再在未用来调参的测试集上重跑。若业务是法律问答,还要评测无选项的问题、引用是否正确、拒答与不确定性处理。即使重跑后 MMLU 分数仍高,也只能支持“在该考试协议下答题表现好”的结论。
另一个较隐蔽的错误是解析器只接受单个 C,却让模型生成“答案是 C,因为……”。若解析器把这段有效回答判为无效,分数会被压低。应先公布输出格式,检查无效答案比例,按预定规则计分;不要在看过测试结果后临时改规则挑一个最好看的成绩。
面试时可以这样说
“MMLU 是覆盖 57 个学科的原版四选一基准,主要看模型在规定提示和答案提取协议下选对标准答案的正确率。原论文常见的是最多给 5 个同学科示例;作者脚本的总体分数按测试题逐题汇总,所以学科题数会影响总分。四选一乱猜的期望是 25%。我看 MMLU 不会只看一个总分,还会核对是否同一题集、shot 数、提示和汇总规则,再看相关学科与错误类型。它不能替代中文业务、工具使用或安全评测;公开题也要注意污染。MMLU-Pro 改了题和选项数,应单独报告,不能直接和原版分数相减。”
若追问“82 分是不是代表 82% 的问题都能答对”,可以答:**只能说这次协议下,评测题约有 82% 被判正确。**真实任务的问题分布、语言、开放式输出及错误代价都不同,要在目标业务上另测。若追问“为什么不能只看总分”,用上面的 55% 例子就能说明:数学 75%,法律只有 50%;决定法律应用能否上线时,法律科与业务错题比总分更直接。