Appearance
Q13 · LangSmith 是什么?如何用于 LLM 可观测性监控?
一个客服 Agent 收到用户的问题:“订单 A123 的耳机能退吗?”网页过了将近 3 秒才显示“请稍后”,客服只看最终一句话,无法判断是模型回答慢、订单接口出错,还是店铺政策没查到。开发者也想知道:刚才到底调用了几次模型?哪个工具耗时最长?模型实际拿到了哪段政策?
LangSmith 是用于追踪、检查和评估 LLM 应用与 Agent 的平台。 它把一次请求中的模型调用、工具调用等步骤记录为有关联的运行记录,便于从最终结果追到具体步骤;也能按项目汇总延迟、错误、token 和反馈等指标。它记录的是应用运行时可采集的信息,不能因此保证答案正确,更不是查看模型私有思维过程的窗口。LangSmith 可观测性概览、可观测性概念
下文的订单 A123、政策和耗时都是虚构示例:假设订单已签收 3 天、耳机未拆封,店铺当前规则是“签收后 7 天内且未拆封,可提交人工退款审批”。这只用来解释追踪和排障,不代表真实商家的规则;Agent 只能给初步建议,不能自动完成退款。
先认清这些术语
| 术语 | 在这里是什么意思 | A123 案例中的对应物 |
|---|---|---|
| LLM / 大语言模型 | 读取输入并生成文字的模型 | 理解用户问的是退款、整理答复 |
| Agent(智能体) | 能按任务选择模型或工具步骤的应用程序 | 客服助手决定查订单、查政策,再回答 |
| Tool(工具) | 应用调用的外部程序或服务 | 订单查询接口、政策检索接口 |
| 可观测性 | 通过运行记录和指标看见系统做了什么、在哪里慢或出错 | 查出 A123 的政策查询用了多久 |
| Run(运行记录)/ Span(跨度) | 一次具体工作及其起止、输入、输出和状态;LangSmith 官方把 run 类比为通用追踪中的 span | 一次“查政策”调用 |
| Trace(追踪) | 同一次操作相关的所有 runs 组成的树,有共同的 trace ID | 用户这次 A123 咨询的整条执行记录 |
| 根 run / 子 run | 外层一次请求及其内部步骤;子 run 可以继续包含下层步骤 | 外层“处理退款咨询”包含模型和工具调用 |
| Project(项目) | 存放同一应用或服务 traces 的容器 | refund-agent-prod 中的客服请求记录 |
| Token | 模型处理文本等内容时使用的计量片段 | 两次模型调用的输入和输出用量 |
| 延迟 / Latency | 从某步开始到结束经过的时间 | “查政策”耗时 1.6 秒 |
| 错误率 | 一组运行中被标记为错误的比例,需说明统计对象 | 政策工具 runs 中有多少次超时 |
| 评测 / Evaluation | 按预先设定的规则或评分标准判断输出质量 | 回答有没有凭已核实的订单和政策作答 |
这里最重要的层级是:一个 project 有许多 traces;一个 trace 有根 run 和子 runs。 一位用户后续又问“多久到账”时,会产生另一个请求 trace;如果应用把这两轮会话关联起来,LangSmith 还可以用 thread 表示这段多轮会话。本文只分析第一轮,避免把“同一次请求”与“同一段聊天”混成一件事。官方说明 run 是工作单元、trace 是一次操作的 runs 集合,thread 才是多个请求 traces 的会话序列。LangSmith 可观测性概念
一次退款咨询在 Trace 里长什么样
假设客服 Agent 按下面顺序处理 A123:先让模型判断用户要咨询退款;用订单工具取回“已签收 3 天、未拆封”;用政策工具查到前述虚构规则;最后让模型结合两份事实生成“符合提交人工审批的初步条件,实际结果以审核为准”。这些动作在一条 trace 下出现,模型和工具分别是可检查的子 runs。LangSmith 的官方入门示例也展示了:外层函数用 @traceable 记录为一次 trace,工具函数与模型调用作为嵌套 span 显示。Tracing quickstart
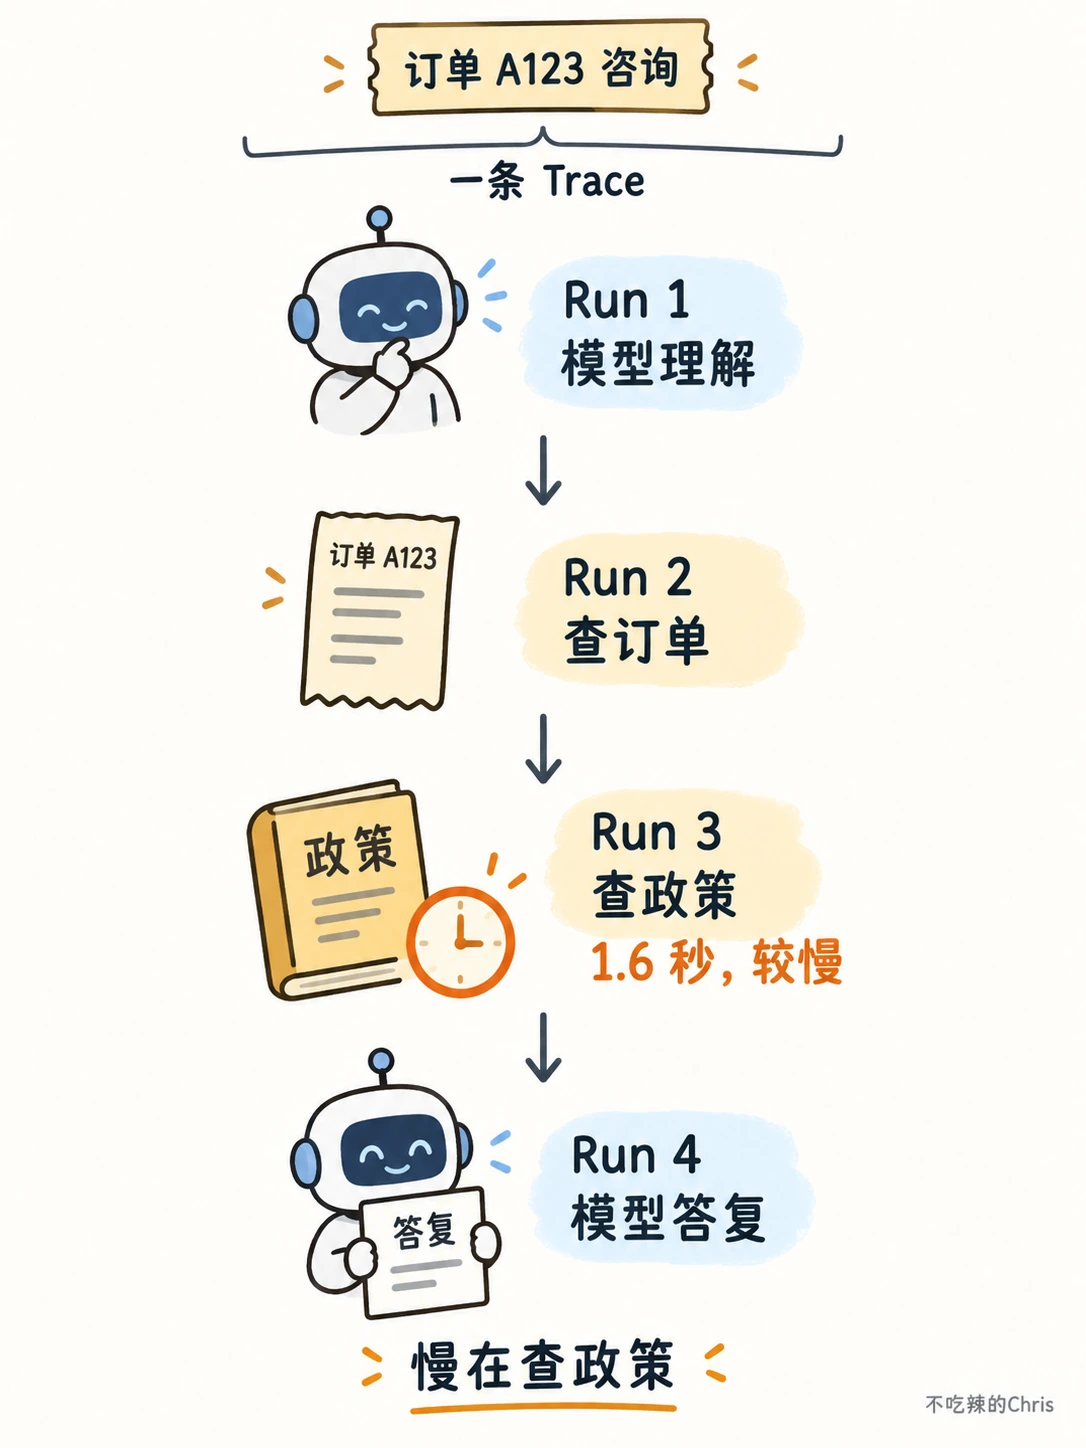
图中的箭头只表示这次假设的执行顺序,大框表示它们属于同一条 trace;实际 Agent 可以有不同步骤或并行步骤。图把“查政策”标成耗时较长,意思是追踪中可以找到慢在哪一步,不代表 LangSmith 会自动修好政策接口。Run 1 和 Run 4 是模型调用,Run 2 和 Run 3 是工具调用;Run 1 至 Run 4 是图中为教学标的序号,并非平台固定名称。
为了看清指标,假设一次实际运行记录如下。数字也是示意数据,不能当作 LangSmith 的默认性能:
| 记录 | 输入与输出的关键事实 | 耗时 | Token | 状态 |
|---|---|---|---|---|
| 根 run:处理 A123 咨询 | 输入是退款问题,输出是初步建议 | 2.8 秒 | 看子模型 runs 汇总 | 完成 |
| Run 1:模型理解问题 | 识别为“退款咨询”,提取订单号 A123 | 0.3 秒 | 输入 120、输出 40 | 完成 |
| Run 2:查订单 | 得到签收 3 天、未拆封 | 0.2 秒 | 不适用 | 完成 |
| Run 3:查政策 | 得到虚构的 7 天、未拆封规则 | 1.6 秒 | 不适用 | 完成但偏慢 |
| Run 4:模型生成答复 | 根据订单事实和政策写初步建议 | 0.5 秒 | 输入 300、输出 70 | 完成 |
四个子步骤共 2.6 秒,根 run 的 2.8 秒还包含编排和传输等示意开销。根 run 的总耗时不要再加到四个子 runs 上,否则同一段时间被重复计算。两次模型调用合计输入 120 + 300 = 420 tokens、输出 40 + 70 = 110 tokens;工具查询不是模型调用,不应凭空填模型 token。实际 token 数据和费用是否能自动显示,取决于接入方式、模型提供商返回的用量信息及价格配置;官方文档说明主流提供商可自动记录,也提供自定义上报方法。LangSmith Cost tracking
现在我们能回答开头的“近 3 秒耗在哪里”:先看根 run 确认这次请求耗时,再展开子 runs,发现政策工具占了 1.6 秒。接着查看它的输入、返回状态及时间;若返回了旧版政策,问题是资料或检索,不应归咎于最后的模型调用。若订单工具给了“已签收 13 天”,而最终回答仍说“3 天内”,则应检查模型实际接收的订单字段和生成答复的那次 run。Trace 的价值是定位证据所在步骤,分析和修复仍由开发者完成。
接入时需要做哪些具体动作
先创建 LangSmith 账号和 API key,在运行客服应用的环境中开启追踪,并指定一个 project。下面的名称仅为本例的项目名,<从平台获取的密钥> 应由安全的环境变量或密钥服务注入,不能写进仓库:
bash
export LANGSMITH_TRACING=true
export LANGSMITH_API_KEY="<从平台获取的密钥>"
export LANGSMITH_PROJECT="refund-agent-demo"
这三个变量分别表示“发送追踪”“向 LangSmith 认证”“把 traces 放进哪个项目”。若账号不在默认区域,还要按账号区域设置 LANGSMITH_ENDPOINT;不要随手填别的区域的地址。Tracing quickstart 这只是启用追踪的配置,不会凭空生成订单或政策工具的详细 runs,仍要让应用的执行步骤被接入层覆盖。
如果 Agent 用受支持的 LangChain 或 LangGraph 组件,官方文档说明可通过环境变量开启对应追踪;先运行一笔不含真实客户资料的 A123 测试请求,再到项目中查看根 run 和嵌套步骤。若用原生 OpenAI 客户端或自写工具,可按官方示例用 wrap_openai(OpenAI()) 包住模型客户端,再以 @traceable(run_type="tool") 包住查订单、查政策函数,并用 @traceable 包住外层客服处理函数。wrap_openai 让模型调用成为可见的子 run;run_type="tool" 给工具调用正确分类;外层装饰器把它们放到同一次请求下。这些名称是 Python SDK 的真实接口,其他语言用各自 SDK 的对应写法。Tracing quickstart、可观测性概念
接入后先核对三件事:一笔请求是否只有预期的一条根 trace;模型与工具 runs 是否挂在正确的父子层级;输入、输出、耗时和错误是否与应用日志或服务端事实相符。比如若图中缺少“查政策”,可能是这段自写代码没被追踪,也可能 Agent 根本没有调用它。只看一张空白看板,无法在两者中选择。追踪失败时还要检查 API key、区域 endpoint、网络与 LANGSMITH_TRACING 设置。Tracing quickstart
从一条 Trace 走向线上监控
单条 trace 用来回答“A123 这次为什么慢”;线上监控则要回答“最近一周是否普遍变慢”。LangSmith 为 tracing project 提供预置看板,包含 trace 数量、延迟、错误率,模型调用数与延迟、token 与费用、工具运行数和错误率等;自定义看板可按 run 名称、标签和元数据分组。官方也支持对错误、延迟和反馈评分等设阈值告警。看板文档、告警文档
假设客服团队担心政策接口:可以先看 查政策 这一类工具 runs 的延迟和错误率,再与整条客服 trace 的延迟对照。如果工具变慢、总耗时一起上升,优先排查检索服务;如果工具正常而最后模型 run 变慢,关注模型服务或提示词长度;如果运行状态都成功却出现大量错误政策答复,技术上的“成功”没有覆盖质量问题,需要结合反馈或评测。统计错误率时要写清分母:是所有客服请求 traces,还是查政策工具 runs,两者不同。
还有一个容易误判的失败路径:政策接口超时,查政策 子 run 记为错误,外层 Agent 捕获它并向用户说“政策暂时无法核实,已转人工”。这时外层请求可能正常结束,但内部工具确实失败;如果只盯根 run 的错误率就会漏掉故障。反过来,若模型未经核对仍宣称“必定可以退款”,即使每个 run 都显示成功,业务答案也可能不合格。监控必须同时看执行健康度与答案质量。
运行记录与评测各回答什么问题
| 做法 | 回答的问题 | A123 示例 |
|---|---|---|
| Trace 排障 | 这一次按什么顺序调用了哪些模型和工具?哪里慢、哪里报错? | 政策工具用了 1.6 秒,返回了哪版规则 |
| 看板与告警 | 一批线上请求的速度、错误和用量有没有趋势变化? | 最近政策查询的超时比例是否上升 |
| 离线评测 | 上线前在固定样本集上,新版本是否比旧版本好? | 准备“3 天未拆封”“13 天已拆封”“政策缺失”等样例比较回答 |
| 在线评测与反馈 | 真实流量中的输出质量是否异常? | 检查是否依据订单和政策回答,收集客服或用户反馈 |
LangSmith 官方把离线评测描述为部署前在策划好的数据集上做基准和回归测试;在线评测则针对生产输出持续检查,可使用代码规则或模型评审。对退款场景,确定性规则例如“政策未查到时不得说已获批”,适合代码检查;“措辞是否清楚”可由人工或评审模型辅助,但评审结果也要抽查。在线评测不是 Trace 自动带来的功能,需要明确评分规则、适用样本和成本;出现争议后可把脱敏案例加入离线样本集。评测类型、在线评审配置
追踪客户请求前先处理隐私
追踪的原始输入和输出可能包含姓名、手机号、收货地址、订单备注和政策文档中的内部信息。不要因为排障方便就把真实客户原文全部上传。 先决定哪些字段确实需要观察,再在发送前脱敏:例如只保留“签收 3 天、未拆封、政策版本号”和随机请求标识;不需要知道客户手机号也能定位政策接口超时。标签和 metadata(给 run 加的键值说明)同样可能泄露个人信息,不能只遮住聊天正文。
LangSmith 官方提供整体隐藏输入与输出的 LANGSMITH_HIDE_INPUTS、LANGSMITH_HIDE_OUTPUTS,也支持对字段进行规则脱敏、隐藏元数据及按请求关闭追踪。整体隐藏会降低排障细节;选择性遮盖需要在真实数据格式上验证,简单正则可能漏掉特殊写法。如果某类请求的规则要求完全不得记录,应该在采集前关闭该请求的追踪,而不是先上传后删除。敏感数据处理文档
面试时可以这样回答
LangSmith 是 LLM 应用的追踪和评估平台。可观测性的核心是把一次用户请求记录为一条 trace,把内部模型、工具和检索调用记录为嵌套的 run,也就是常说的 span。比如客服 Agent 处理 A123 退款咨询,我会看到它是否理解了意图、查了什么订单和政策、哪一步耗时或报错,以及模型调用的 token 用量。单条 trace 用来排障,项目看板和告警用来监控一批请求的延迟、错误与成本;答案是否真的符合政策,还要靠反馈和离线或在线评测。接入时用 API key 和
LANGSMITH_TRACING开启记录,对受支持框架使用集成,对自写函数用@traceable,并检查父子 runs 是否完整。上线前先脱敏输入、输出和元数据,必要时关闭敏感请求的追踪。它帮我找问题发生在哪一步,但不替代业务校验或隐私设计。
如果被追问“页面都显示 success,为什么用户仍说错了”,可以举出“模型把已签收 13 天写成 3 天”的情况:运行成功只表示调用完成,业务正确性仍要评测。如果被追问“工具超时为何整体请求没报错”,可以说明 Agent 捕获异常并给了安全的转人工答复,根 run 可正常完成,但子 run 的错误仍应计入工具故障监控。