Appearance
Q122 · 什么是 Plan-and-Solve Prompting(PS)技术的核心思想及其要解决的主要问题?
小卖部原有 3 箱饮料,每箱 12 瓶;卖出 8 瓶后,又补进 5 瓶。现在把手头的饮料平均分给 3 个班,每班能分到几瓶?这道题不难,但如果答题者看到“卖出”就急着做减法,再直接平均分,就可能漏掉“补进 5 瓶”。大语言模型生成逐步解答时也会出现这种问题:每一行单看像是有道理,整条解答却少了一步。
Plan-and-Solve Prompting(PS,先计划再求解的提示法)的核心是:在回答之前,先让模型把题目拆成有顺序的小任务,再沿着这些小任务解答。它是写给模型的提示词策略,重点缓解多步推理中的“漏步”。原论文还提出指令更细的 PS+,希望进一步减少计算错误、改善推理过程质量。Wang 等人的 ACL 2023 原论文把三类常见错误归为计算错误、漏步和语义误解,并分别说明 PS 与 PS+ 的设计目标。
先把术语和数字说清楚
| 术语或符号 | 在这里是什么意思 | 饮料题中的对应物 |
|---|---|---|
| 大语言模型(LLM) | 接收文字输入并生成文字输出的模型;它写出的步骤仍可能有错 | 生成计划、算式和最终回答的答题者 |
| 提示词(prompt) | 发给模型的题目和回答要求 | 饮料题,加上“先列计划,再逐步执行”的要求 |
| 思维链(Chain of Thought,CoT) | 把从题目到答案的中间步骤写成连续文字的做法 | 写出 3 × 12、减 8、加 5、除 3 |
| Zero-shot CoT(零样本思维链) | 不在本次提示里给已解好的示范题,而用一句引导语请求模型逐步解题 | 给饮料题加“让我们一步一步思考”一类要求 |
| PS | 先拟解题计划,再按计划逐步求解的零样本提示方法 | 先列“原有→卖出后→补进后→平均分” |
| PS+ | 在 PS 之上,进一步提醒模型找出相关数字、处理计算与常识细节的提示方法 | 明确“3 箱、每箱 12 瓶、卖出 8、补进 5、分 3 班”,并核对中间值 |
| 计划 | 要做哪些小任务及其顺序;它本身还不是答案 | 四个动作:算原有、扣卖出、加补进、再平均分 |
| 中间值 | 完成某个小任务后得到、下一步需要用的数 | 36 瓶、28 瓶、33 瓶 |
| 漏步错误 | 题目有一个必要动作,却在推理过程中被跳过 | 从 28 瓶直接除以 3,忘了补进 5 瓶 |
| 计算错误 | 解题步骤选对了,但算式结果算错 | 把 3 × 12 写成 32 |
| 语义误解 | 没有正确理解题目中的关系或条件 | 把“补进 5 瓶”理解成“又卖出 5 瓶” |
这里的“零样本”只说当前提示没有附带已解好的示例题,并不表示模型没有经过训练,也不保证它第一次就能答对。“计划”是本题解答的步骤表,不意味着有项目管理器、工具调度器或长期任务状态。
PS 为什么比一句“逐步思考”多了一层约束
普通的 Zero-shot CoT 会用简短引导语让模型生成中间步骤,例如原始研究中的 “Let's think step by step”。这能让答案不只剩一个数字,却没有明确要求模型先检查“需要完成哪些子任务”。模型可能生成一个看似连贯的局部过程,然后在没有处理完题目条件时就收尾。Zero-shot CoT 原论文研究的是这种不附示范题的逐步推理引导;PS 论文针对它的漏步现象提出更明确的两段式要求。
PS 的第一层要求是拟计划:识别目标、把总题拆成小任务,并排列依赖关系。饮料题不能先分给 3 个班,再补货;“平均分”依赖“现有多少瓶”,而“现有多少瓶”依赖“原有、卖出、补进”三个数量变化。
第二层要求是按计划求解:逐项执行,而不是把计划当成漂亮的开头,后面仍凭直觉跳跃。执行时应能看到每一步用到哪个已知量,产生哪个中间值。如果写出的计划有 4 步,解答只完成第 1、2、4 步,就能直观看出中间缺了什么。
这不是说模型先在一个独立系统里保存计划、再由另一个执行器读取。原论文的提示策略让同一个模型在其生成的解题文字里先规划、后求解。论文实验另外使用了一个答案提取提示,从前面的推理文字中规范化抽取最终答案,便于评价;那不等于 PS 必须把“拟计划”和“执行”拆成两次模型调用。论文 PDF 的方法与实验设置和作者代码仓库可以核对这一流程。
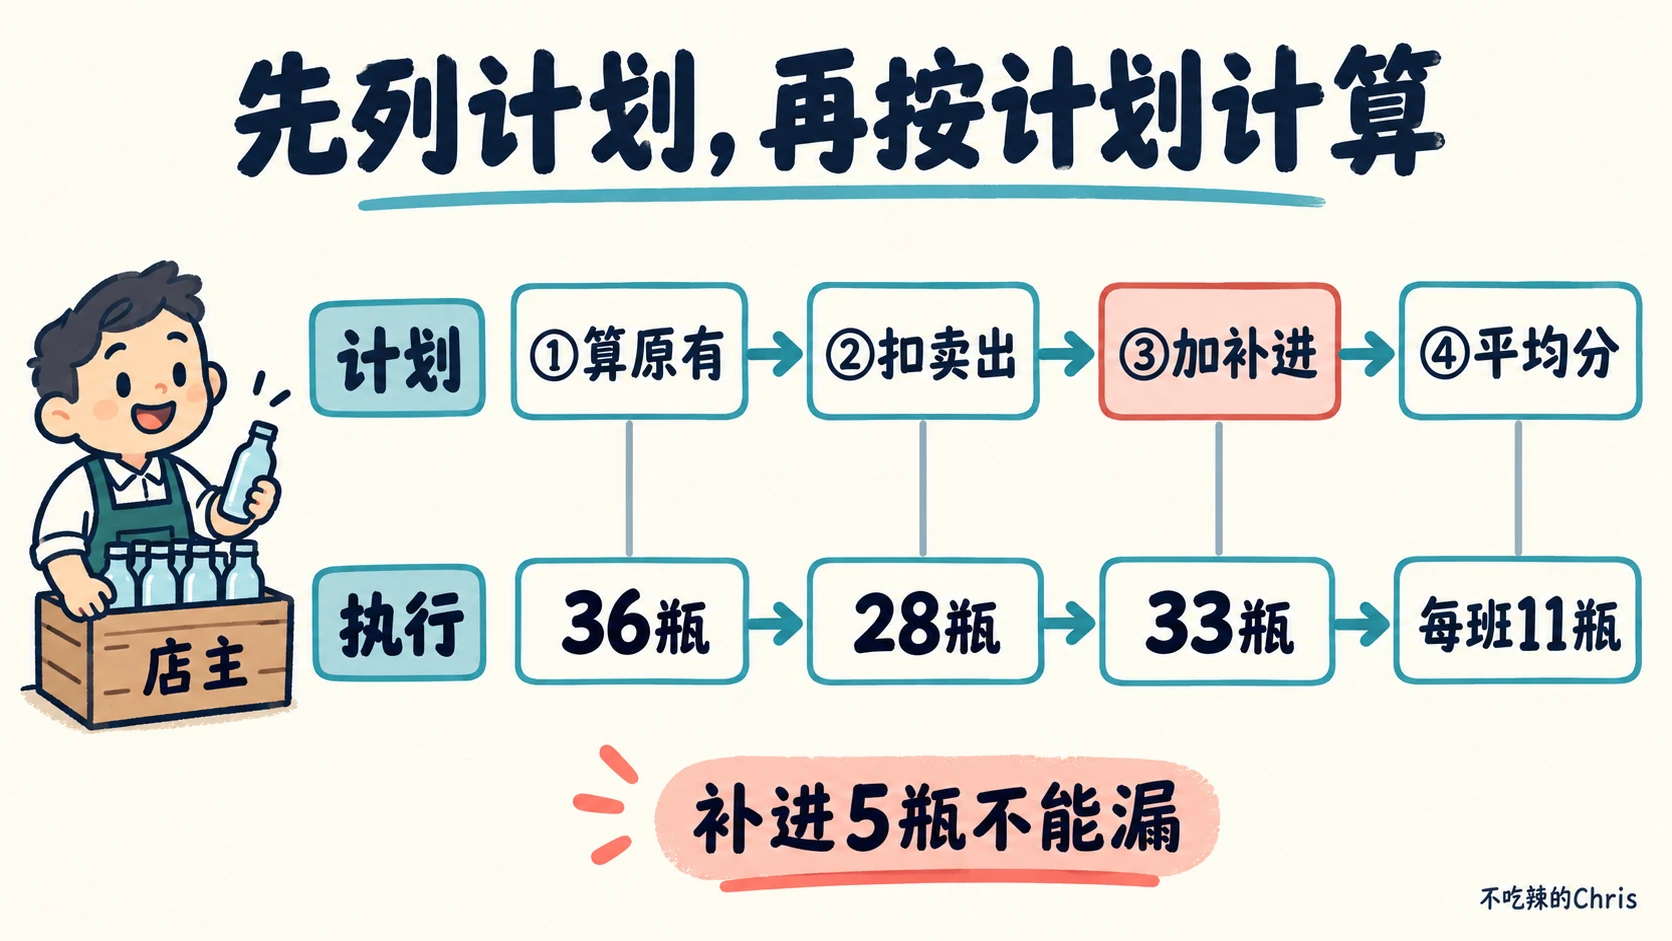
图里“补进 5 瓶”被单独放成一步,是因为它正是容易被遗漏的条件。图中的数字用于教学演示,并非论文中的实验题目或模型输出。
用同一道题走完计划与执行
先固定题意:所有饮料规格相同,补进的 5 瓶发生在卖出 8 瓶之后,剩余饮料可以整瓶平均分给 3 个班;每箱 12 瓶,“3 箱”不是 3 瓶。目标是“每班分到几瓶”,不是只求小卖部最后总共有几瓶。
下面是一段教学改写的中文 PS 提示,不是论文英文提示的逐字翻译:
小卖部原有 3 箱饮料,每箱 12 瓶;卖出 8 瓶后补进 5 瓶。把现在的饮料平均分给 3 个班,每班几瓶?请先列出解决此题所需的步骤与顺序,再依照这些步骤计算,最后给出每班瓶数。
面对这个提示,一条合格的计划可以写成:
- 算原有饮料总瓶数。
- 扣除卖出的 8 瓶。
- 加上补进的 5 瓶,得到现在的总瓶数。
- 将现在的总瓶数平均分给 3 个班。
随后按顺序执行,且每一步都把前一步的结果作为下一步输入:
| 子任务 | 用到的数字 | 中间计算 | 这一步结束后知道什么 |
|---|---|---|---|
| 原有多少 | 3 箱、每箱 12 瓶 | 3 × 12 = 36 | 原有 36 瓶 |
| 卖出后多少 | 原有 36 瓶、卖出 8 瓶 | 36 − 8 = 28 | 卖出后剩 28 瓶 |
| 补进后多少 | 剩 28 瓶、补进 5 瓶 | 28 + 5 = 33 | 现在有 33 瓶 |
| 每班多少 | 现有 33 瓶、3 个班 | 33 ÷ 3 = 11 | 每班 11 瓶 |
最终答案是每班 11 瓶。回头用题目核验:3 个班一共分去 33 瓶,等于小卖部现在拥有的 33 瓶;“补进”使瓶数从 28 上升到 33,没有在解答里消失。这里的“核验”是我们在教学中加的检查动作,不能声称 PS 提示本身保证模型一定会自检成功。
漏步是怎样发生的,PS 怎样帮助发现
看一条可能的错误路线:原有 3 × 12 = 36 瓶;卖出 8 瓶后还剩 28 瓶;接着立刻说“平均分给 3 个班”。它跨过了“补进 5 瓶”。无论之后怎样处理 28 ÷ 3,答案都不可能是题目要求的最终分配结果。这个错误的要点不是除法难,而是输入给除法的数量错了。
若提前列出“原有→卖出→补进→平均分”四步,执行记录中只有三步,漏掉“补进”就更显眼。这就是 PS 的核心直觉:把“解题需要覆盖哪些条件”放在“边想边算”之前。它不依赖在提示里手工写一套做好的相似例题,所以仍属于零样本提示。
但“显眼”不代表“必然避免”。模型可能先列出正确计划,执行时仍跳过第 3 步;也可能计划本身就漏了“补进”,此时后续认真执行也会得出错误结果。在实际应用里,可以把每个必要条件是否被使用当作检查项,但这属于额外的验证设计,超出了 PS 提示词本身。
PS+ 额外提醒了什么
如果题目包含很多数字,模型可能连相关数量都没抽全,或者计划正确却把中间值算错。PS+ 沿用“先计划、再求解”的结构,同时给出更细的提示,让模型关注抽取相关变量和数字、逐步计算中间结果、留意计算及常识关系。这里“变量”只是会随题目变化的量:箱数、每箱瓶数、卖出数、补进数、班级数。PS 论文的方法段说明 PS+ 是为改善计算和生成步骤质量而加的指令,不是另一个模型架构。
对于饮料题,PS+ 风格的教学改写可以要求:
先列出题中每个相关数量及其作用,拟出完整步骤,再逐步计算并写出中间瓶数;特别检查“卖出”与“补进”对数量的方向,最后核对每班数乘以班级数是否等于现有总数。
这样做能帮助模型避免把“3 箱”直接当 3 瓶,也能让 36、28、33、11 这些中间值暴露出来,便于检查。但指令再细也只是增加约束;如果模型把 3 × 12 错算为 32,或者把“补进”理解为“拿走”,它仍会沿着错误计划或错误数字继续写下去。
| 同一维度 | Zero-shot CoT | PS | PS+ |
|---|---|---|---|
| 提示的基本动作 | 请求逐步思考 | 先拟计划,再按计划求解 | 先拟计划并求解,再增加数字、变量与计算细节提示 |
| 是否需要在本次提示放示范题 | 不需要 | 不需要 | 不需要 |
| 是否明确要求列出子任务顺序 | 通常不明确 | 明确要求 | 明确要求 |
| 针对的主要问题 | 希望出现中间步骤 | 重点缓解漏步 | 继续缓解漏步,并试图改善计算错误 |
| 这道题里可看到什么 | 可能直接写算式 | 先写四步,再算 | 先抽取 3、12、8、5、3 的含义,再按计划逐项计算 |
| 能否保证正确 | 不能 | 不能 | 不能 |
论文在其所用的 GPT-3 模型与数据集上报告了 PS、PS+ 相对 Zero-shot CoT 的改进;这是特定实验条件下的结果,不能推出当前任意模型、任意题型都必然提高准确率。论文对随机抽取的 100 道 GSM8K 题做错误分析,漏步问题的计数从 Zero-shot CoT 的 12 道降到 PS+ 的 7 道,但语义误解两者都是 27 道。这也说明更细的步骤提示没有解决所有理解问题。论文实验与错误分析
几条看起来会规划、实际仍会失败的路径
计划本身错误。 模型把“补进 5 瓶”误认成“又卖出 5 瓶”,于是规划“算原有→减 8→减 5→分 3 班”。后续每一步都依计划执行,最后仍然错,因为对题意的理解已经错了。面对含糊的业务语言,应该先澄清事实,或用业务规则核对“补进”代表库存增加;不能只增加“请认真思考”。
计划正确,计算错误。 模型列了四步,却把 3 × 12 写成 32;后面的减、加、除都以 32 为起点。PS+ 提醒算中间值有帮助,但不能把文字模型变成可靠计算器。若结果会用于订单、报销或财务决策,应让确定性的程序计算并校验数字,把模型输出当作待验证解释。
计划正确,执行漏项。 模型计划列了“补进后多少”,真正求解时仍从 28 直接去分班。此时可逐项对照计划与执行记录,缺哪一行就要求重算,或由程序检查必要条件是否被覆盖。提示词是一道软约束,检查器才可能把“必须覆盖条件”变成可验证的门槛。
题目本身条件不足或有歧义。 假设改成“补进几瓶后平均分给 3 个班”,却不告诉补进数量,就无法唯一算出每班多少。先列计划只会发现缺了一个输入,不能凭空补出正确数据;合理回答是说明缺少补进数量,并请提问者补充。
这些边界解释了 PS 的适用位置:多步、顺序关系清楚、容易漏条件的题目值得尝试;极简单的一步题可能增加输出长度却没有明显收益;专业事实核查、模糊需求澄清和严谨算术仍需相应的数据、规则或工具。评估是否值得使用时,应在同一批题上分别看最终正确率、漏步率、算错率、语义误解率,并记录输出长度与延迟,不能只拿一段漂亮的计划当成功。
它和 Agent 的“规划执行”不是同一件事
名字里的“Plan-and-Solve”容易让人联想到 Agent 先计划、再调用搜索、计算器或数据库。PS 原论文讨论的是如何写提示,让模型在文字推理中先拆题再答题。它本身没有规定外部工具接口、权限、调用循环、失败重试、状态保存或真实世界动作。即便模型写出“下一步查询库存”,也只是文字,除非应用程序真的授权并执行了库存查询。作者仓库与原论文展示的是提示法与推理实验,不应把它直接描述为完整的 Agent 运行时。
两者可以组合:应用程序先检索真实库存,再把可信数字和问题交给模型用 PS 风格组织回答;计算环节再由程序验算。此时检索、权限和验算来自应用层设计,PS 只负责让模型更清楚地组织解题步骤。另一种区分是 Tree of Thoughts 会显式生成、评价多个候选分支并搜索;PS 的基本形式沿着一份计划完成一条解答,并不自带分支搜索或回退机制。
面试中可以怎样回答
“PS 是 Plan-and-Solve Prompting,是一种零样本提示法。普通 Zero-shot CoT 只是请模型逐步思考,模型可能写了几步却漏掉题目里的某个必要步骤。PS 先要求模型把任务拆成有顺序的小任务,再逐项求解,所以主要针对漏步。PS+ 在此基础上进一步提醒抽取相关数字、算中间值、注意计算与常识关系。比如先算饮料原有 36 瓶、卖出后 28 瓶、补进后 33 瓶,再除以 3 得到每班 11 瓶。它是提示词方法,不保证计划或计算正确,也不等同于 Agent 真正调用外部工具;要做可靠业务流程,还需要澄清输入和独立校验。”
如果追问“PS 是不是两个模型调用”,可以答:不是定义要求。论文里的“先计划、再求解”描述生成解题过程的顺序;实验还有便于评测的答案提取阶段,不能把它当成每个实际 PS 应用必须单独调用一次“规划模型”、再调用一次“执行模型”。如果追问“PS+ 是否能杜绝计算错误”,应答:不能。它是更细的语言指令,能减少某些错误,但严谨计算仍应交给可验证的计算过程。
资料依据
- Wang 等,Plan-and-Solve Prompting,ACL 2023:PS、PS+ 的定义、实验范围和错误分析;论文 PDF含具体方法与表格。
- 论文作者代码仓库:原始实现与实验材料。
- Kojima 等,Large Language Models are Zero-Shot Reasoners:Zero-shot CoT 的原始研究。